Hilfsmittel Mathematik 1 SS09
Inhaltsverzeichnis |
Autoren
Michael Gäbler, Daniel Glaser
Approximation von Funktionen
Was bedeutet Approximation?
Approximation bezeichnet ein Näherungsverfahren im mathematischen Sinn. Dabei ist Sie ein Hilfsmittel, die computergesteuerte Lösungsverfahren beschleunigen oder erst möglich machen kann.
Exponentialfunktionen
Bei der Analyse von Algorithmen führen diese immer zu Kurven. Dabei tritt beim Näherungsverfahren eine Punktmenge im Kartesischen Koordinatensystem auf, die einer Exponentialfunktion angenähert werden kann. Um jedoch den Aufwand eines Algorithmus exakt bestimmen zu können, wird eine Gerade benötigt. Diese besitzt einen exakten Anstieg bzw. eine exakte Funktion.
Damit eine Exponentialfunktion als Gerade dargestellt werden kann, wird diese in ein kartesisches Koordinatensystem mit einer logarithmischen y-Achse überführt.
Diese Funktionen besitzen im Allgemeinen folgende Form:
y = T(n) = a * b^n , mit b \geq 1
Der konstante Faktor a ist dabei der Schnittpunkt mit der y-Achse.
Nach einer Umformung dieser Allgemeinen Funktion ergibt sich die Gleichung:
log y = f(n) = log(a * b^n) = n * log b + log aAus dieser Gleichung wird die Funktion als Gerade z = f(n) = n * α + β, mit z = log y, α = log b (ist der Anstieg der Geraden) und β = log a (Ist der Schnittpunkt mit der y-Achse), dargestellt.
Wie geht man nun in der Praxis vor?
In der Praxis macht man dies genau umgekehrt. Zuerst zeichnet man die ermittelten Daten der Wertepaare in ein Koordinatensystem mit logarithmisch eingeteilter y-Achse ein. Wenn sich dabei eine Gerade ergibt, so kann daraus die Funktion y = T(n) = a*b^n bestimmt werden. Dabei ist der Anstieg log b die Basis b und der konstante Faktor a der Schnittpunkt mit der y-Achse.
Mit Hilfe von Gnuplot kann man diese Funktionen grafisch darstellen.
Beispiel:
Darstellung der Funktionen T(n)= 10*2^n; T(n)=10000*2^n; und T(n)=10^n
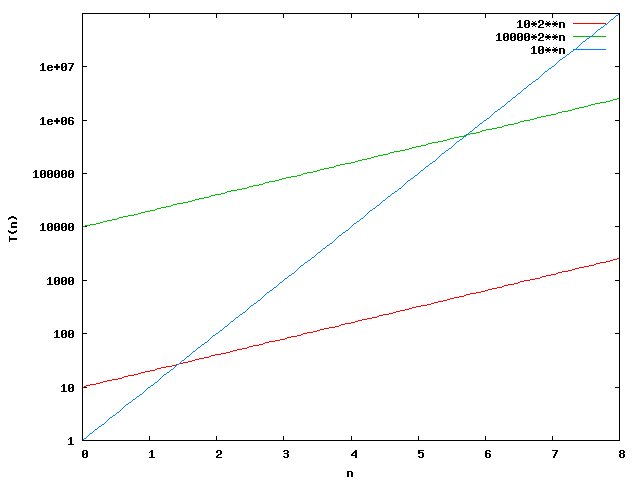
Effizienz von Algorithmen: Exponentieller Aufwand
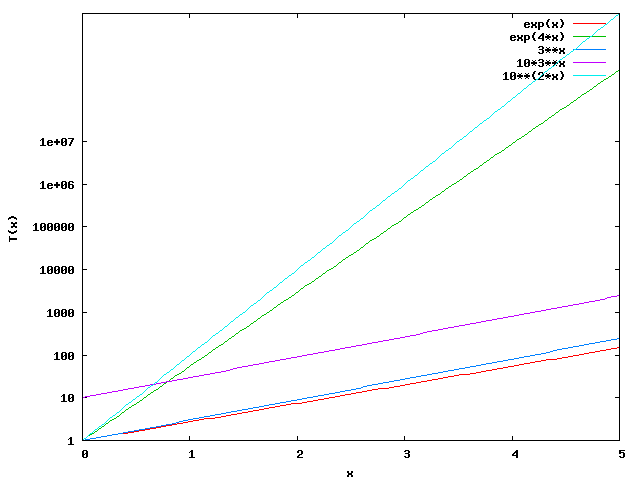
Des Weiteren stellen Exponentielle Funktionen mit der Form:
T= f(x) = a^b^*^xin einem kartesischen Koordinatensystem mit einer logarithmischen y-Achse eine Gerade dar.
Beispiel: Darstellung der Funktionen: T(x)=exp x; T(x)=exp 4^*^x; T(x)=3^x; T(x)=10*3^x; T(x)=10^2^*^x
Lineare Reggression
Im Logarithmischen Koordinatensystem ist es viel einfacher eine Gerade anhand der eingetragenen Punkte zu verlegen als eine Exponentialfunktion im normalen Koordinatensystem zu bestimmen.
Als Lineare Regression bezeichnet man die mathematische Methode zur Bestimmung einer Geraden im logarithmischen Koordinatensystem, anhand der verstreuten Messpunkte. Dabei wird die Gerade y = f(n) = a*n+b gesucht. Ziel der Linearen Regression ist es dabei, die gerade so zu bestimmen, dass der maximale Abstand zwischen der Geraden und den Messpunkten möglichst klein ist.
Bei der Linearen Regression geht man wie folgt vor:
max|T(n)-(a*n+b)|->minimalDurch diese Formel besteht die Gefahr, dass wenn nur ein einziger Messpunkt erheblich daneben liegt, die Gerade sehr ungenau wird. Da es Allerdings für jeden Messpunkt gelten muss, so wird die gesuchte Funktion als Summe der Abstände der einzelnen Messpunkte dargestellt:
Durch diese Formel kommt allerdings das Problem auf, dass zur Bestimmung des Minimums die erste Ableitung benötigt wird. Allerdings ist die Betragsfunktion an der Stelle x = 0 nicht differenzierbar.
Bei der Methode der kleinsten Fehlerquadrate von Gauss, wird die Formel Quadriert. Dadurch ist diese Differenzierbar, aber die Suche nach dem Minimum wird dadurch nicht beeinflusst.
\sum_{n}(T(n)-(a*n+b))^{2}->minimalUm das Minimum zu bestimmen, wird nun die erste Ableitung gebildet.
f'(x)=0Da man das Minimum nach a und b benötigt, so muss jeweils nach a und b abgeleitet werden.
Ableitung nach a:
2*\sum_{i=1}^{r}(T(i)-a*i-b)(-i)->0Ableitung nach b:
2*\sum_{i=1}^{r}(T(i)-a*i-b)(-1)->0Durch Vereinfachung erhält man die sogennante Normalengleichung:
Durch Umstellen nach a bzw. b erhält man nun die gewünschten Parameter für die Regressionsgerade:
Daraus entstehen folgende Endformeln:
Anhand verschiedener Meßpunkte kann nun die Funktion bestimmt werden, damit eine Gerade entsteht. Um dies zu verdeutlichen, folgt nun ein Beispiel:
Beispielrechnung:
folgende Meßwerte sind gegeben:
T(1)=2
T(2)=4
T(3)=5
T(4)=9
T(5)=13
T(6)=19
Nun werden die verschiedenen Größen für a und b berechnet.
Vorgehensweise, um Summen, z.B.:\sum_{i=1}^{r}i*T(i) ausrechnen zu können:
r ist die Anzahl der Meßwerte. Daher ist r = 6
i gibt den Startwert an. i ist im Beispiel 1, daher wird die Formel wie folgt ausgerechnet:
\sum_{i=1}^{r}i*T(i)= (1*2) + (2*4) + (3*5) + (4*9) + (5*13) + (6*19) = 240 \sum_{i=1}^{r}i= 1+2+3+4+5 = 21 \sum_{i=1}^{r}T(i)= 2+4+5+9+13+19 = 52 \sum_{i=1}^{r}i^{2}= 1^2 + 2^2 + 3^2 + 4^2 + 5^2 + 6^2 = 91 (\sum_{i=1}^{r}i)^{2}= (1+2+3+4+5+6)^2 = 441Nun werden die berechneten Größen in die Formeln für a und b eingesetzt:
Parameter für die Regressionsgerade im kartesischen Koordinatensystem.
Um im logarithmischen Koordinatensystem eine Gerade herauszubekommen, muss diese Gleichung noch in die Form T(n)=a*b^{n} umgwandelt werden.
Es gilt: Die Basis b = log a
Die Basis b = log 3,3 b = 0,519
dabei ergibt sich für unser Beispiel folgende Exponentialfunktion:
T(n)=3,3*0,519^{n}Polynomfunktion
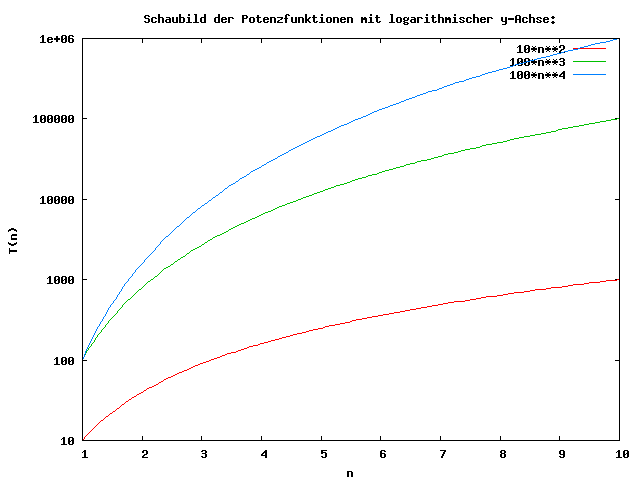
Was entsteht, wenn eine Potenzfunktion in der Form T(n) = c*n^k, k \geq 1, z.B. T(n)=10n^2 in einem Koordinatensystem mit logarithmisch eingeteilter y-Achse dargestellt wird?
Es entsteht eine Kurve (Parabel).
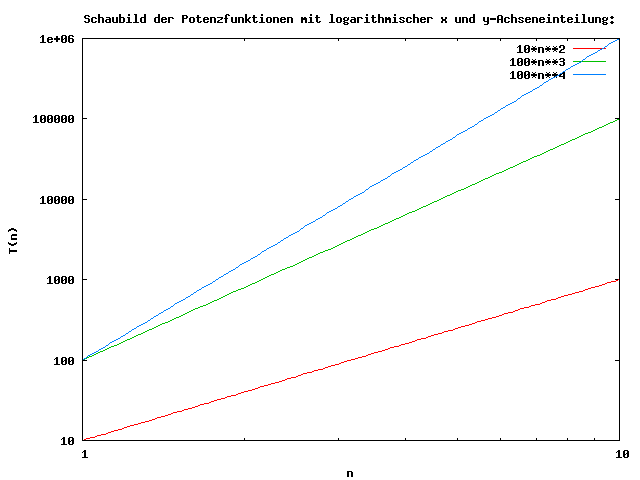
In der folgenden Rechnung soll nachgewiesen werden, dass nur dann eine Gerade entsteht, wenn beide Achsen logarithmisch eingestellt sind.
Dabei wird aus:
z = f(log n) = α * log n + β, mit z = log y, α = k und β = log c.
Daraus folgt: log y = f(n) = log (c*n^k) = k * log n + log c, für n>0.
Nun zeichnet man wiederum die ermittelten Daten der Wertepaare in das Koordinatensystem ein.
Der Anstieg mit der y-Achse bei n=1 gibt den konstanten Faktor c an. Der Exponent k ist der Anstieg der Geraden.
Der Graph wird also tatsächlich zu einer Geraden, wenn beide Achsen logarithmisch eingestellt sind.
Um den Unterschied grafisch zu sehen, folgen nun ein paar Potenzfunktionen mit logarithmischer y-Achse:
Und nun mit logarithmischer x-und y-Achse:
Wie sieht das ganz nun bei Polynomfunktionen aus:
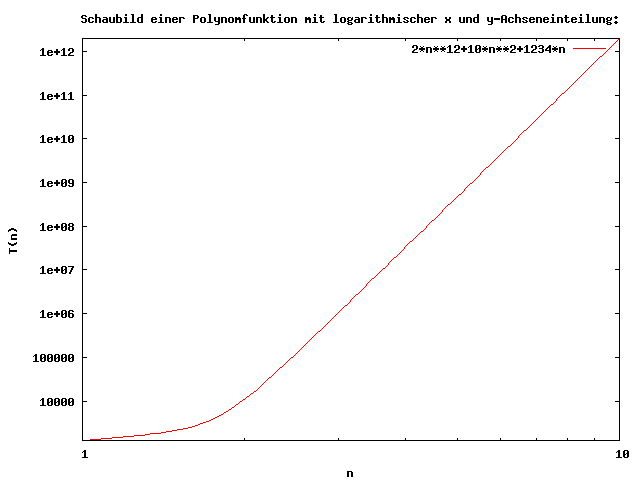
Bei diesen Graphen handelt es sich um keine Gerade, weil eine Summe gebildet wird.
Schließlich kann man davon ausgehen das nicht bei jeder Funktion eine Gerade entsteht.
Deshalb sind andere Untersuchungsmethoden notwendig um auf das gewünschte Ergebnis zu kommen.
Approximation von Polynomfunktionen
Damit bei Polynomfunktionen eine Gerade entstehen kann, muss ein Näherungsverfahren angewendet werden.
Polynomfunktionen bestehen aus mehreren Basisfunktionen der folgenden Form:
Ziel ist es, die Methode der kleinsten Fehlerquadrate auf Polynomfunktionen der Form:
f(c_0,c_1,...,c_m,x)=\sum_{i=0}^{m}c_ig_i(x), mit Basisfunktionen gi:x\rightarrow x^i
anzuwenden.
Nun werden die Koeffizienten c_i , für i = 0,1,...,m gesucht.
Dabei wird die Methode der kleinsten Fehlerquadrate angewendet auf die Formel:
Das bedeutet, dass die Summe der Abstände zwischen der gesuchten Funktion und den Messwerten minimal sein soll. Dazu bildet man die Ableitung für sämtliche c_i und setzt diese gleich null.
Nun multipliziert man die Ableitung aus und bringt y_k auf die rechte Seite.
Die Normalengleichungen für 0 ≤ j ≤ m lauten:
g_j geben Basisfunktionen zwischen 0 und m an. Nun trägt man die Formeln in ein lineares Gleichungssystem ein. Dabei erhält man für alle c (=konstante Faktoren) eine Lösung.
Um dieses Gleichungssystem zu lösen, werden für g_j alle Basisfunktionen angenommen.
Um das veranschaulichen zu können, benutzt man Matrizen:
Mit \vec y = (y_1,...,y_n)^T und der Matrix:
ergibt sich die Normalgleichung in der Form:
A^TA\vec c = A^T \vec yDer reellwertige Vektor \vec c=(c_0,c_1,...,c_m)^T bezeichnet die gesuchten Koeffizienten.
Dadurch kann man dieses Gleichungssystem lösen und als Ergebnis erhält man die Faktoren für die einzelnen Polynome.
Um die Koeffizienten der wählbaren Basisfunktionen bestimmen zu können, bedient man sich dem Computerprogramm „Maple“.
Maple-Worksheet (Maple 11)
restart:
with(linalg):
with(plots):
x := [0, 1, 2, 3, 4, 5, 6, 7, 8, 9];
y := [0, 4, 9, 16, 25, 36, 49, 64, 81, 100];
g := x->x^0, x->x, x->x^2, x->x^3;
n := nops(x);
m := nops([g])-1;
A := matrix(n, m+1, 0):
c := vector(m, 0):

for k to n do
  for i to m+1 do
    A[k, i] := g[i](x[k]);
  od:
od:
evalm(A);
AT := transpose(A):
left := evalm(AT&*A):
right := (AT&*y):
c := evalf(linsolve(left, right));
                      x:=[0, 1, 2, 3, 4, 5, 6, 7, 8, 9]
                  y:=[0, 4, 9, 16, 25, 36, 49, 64, 81, 100]
                                           2        3
                  g:=x -> 1, x -> x, x -> x , x -> x
                                    n:=10
                                     m:=3
c:=[0.1762237762,2.635198135,0.8671328671,0.008158508158]
h := 0:
for i from 0+1 to m+1 do h := h+c[i]*g[i] od:
pkt := [seq([x[i], y[i]], i = 1 .. n)]:
bild1 := plot(pkt, 0 .. x[n], 0 .. y[n], style = point, symbol = diamond);
bild2 := plot(h(xx), xx = x[1] .. x[n], color = BLACK);
display(bild1, bild2, labels = ['x', 'h(x)']);
Übungsaufgaben
Lösungen
Folien
- Hier sind die Folien zur Vorlesung