In den Beispielen wurden übersichtshalber nur Zeichen berücksichtigt, die im Wort enthalten sind. Allen anderen ist der Wert m zugewiesen. Außerdem sind sie praktischerweise nach dem Vorkommen in der ASCII-Tabelle sortiert.
Programmbeispiel
Laufzeitanalyse
Obwohl auch hier beim Worst-Case-Szenario der Algorithmus die selben Probleme aufweißt wie der naive Algorithmus, ist dieser Algorithmus im Mittel jedoch viel schneller bei der Abarbeitung. Vor allem, wenn es sich um einen gewöhnlichen Text handelt. Dies kann sehr gut dadurch veranschauligt werden, dass bei dem Algorithmus die Möglichkeit besteht, unnötiges Suchen an Stellen, wo niemals das Wort vorkommen kann, zu vermeiden. Doch um diesen Vorteil ausnutzen zu können, muss davor D berechnet werden. Der Aufwand liegt dabei in \mathcal{O}(m). Nach dieser einmaligen Vorverarbeitung arbeitet der eigentliche Suchalgorithmus in \mathcal{O}(n) (im Average-Case) und ist somit potenziell deutlich schneller als das naive Verfahren.
Weitere Algorithmen
String-Matching mit endlichen Automaten
Es gibt viele Wortsuchalgorithmen, die mit Hilfe von endlichen Automaten arbeiten. Eins davon wird hier vorgestellt.
Die Motivation dahinter ist die Effizienz eines solchen Algorithmus. Bei der Suche nach einem Wort (in dem Zusammenhang auch Muster bzw. pattern genannt) wird jedes Textzeichen nur ein einziges mal untersucht. Diese Untersuchung benötigt, anders als bei den vorherigen Verfahren, stets eine konstante Zeit. Somit schafft es der Algorithmus einen Aufwand zu erreichen, der in \Theta(n) liegt, wenn man nur die Matchingzeit betrachtet.
Für die Veranschaulichung wird ein DEA mit M = (Q,\Sigma , q_0 , E, \delta ) verwendet. Dabei ist das Eingabealphabet \Sigma nichts weiter als das am Anfang unter Allgemeines und Festlegungen festgelegte Alphabet und besteht demzufolge aus den selben Elementen. Da das Wort entscheidend für die Gestaltung des Automaten ist und nicht der Text, besitzt der Automat m+1 Zustände: Q = \{ 0,1,2,...,m-1,m\} , wobei q_0 = 0 ist. Es gibt nur einen Endzustand, nämlich A = \{ m\} . Diesen gilt es zu erreichen, damit M das Signal geben kann, dass das Wort im Eingabetext des Automaten gefunden wurde. Jetzt fehlt nur noch die Übergangsfunktion \delta, die ein Wort im Text erkennen soll. Um diese Übergangsfunktion aufzustellen, gibt es eine Vorschrift.
Vorschrift
Compute-Transition-Function(w,\Sigma)
1 m ← länge[w] 2 for q ← 0 to m
3 do for jedes Zeichen a \in \Sigma
4 do k ← min(m+1,q+2)
5 repeate k ← k - 1
6 until w_k \sqsupset w_q a
7 \delta (q,a) ← k
8 return \delta |
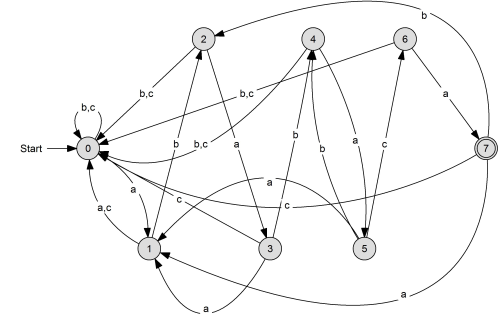
DEA für w = ababaca
Beispiel
M = (Q,\Sigma , q_0 , E, \delta ), mit
- Q = \{ 0,1,2,3,4,5,6,7\}
- \Sigma = \{ a,b,c\}
- q_0 = 0
- E = \{ 7\}
- \delta
Der Knuth-Morris-Pratt-Algorithmus
Obwohl die Suche beim endlichen Automaten eine akzeptable Laufzeit ausweist, stellt die Vorverarbeitung und damit die Berechnung der Überführungsfunktion mit einem Aufwand in \Theta(m |\Sigma|) ein Hindernis dar. Eine vielversprechende Lösung bietet der KMP Algorithmus. Statt der \delta wird eine Hilfsfunktion \pi (auch Feld genannt) zum Einsatz für die Vorberechnung kommt. Deren Aufwand liegt in nur \Theta(m). Das Matching selber ist vom Aufwand her der selbe, wie schon mit endlichen Automaten.
KMP-Matching-Algorithmus
KMP-Matcher(t,w)
1 n ← länge[t] 2 m ← länge[w]
3 \pi ←Compute-Prefix-Function(w)
4 q ← 0
5 for i ← 1 to n
6 do while q > 0 und w[q+1] ≠ t[i]
7 do q ← \pi[q]
8 if w[q+1] = t[i]
9 then q ← q+1
10 if q=m
11 then print "Das Wort tritt mit der Verschiebung" i-m "auf"
12 q ← \pi[q] | |
Compute-Prefix-Function(w)
1 m ← länge[w] 2 \pi[1] ← 0
3 k ← 0
4 for q ← 2 to m
5 do while k>0 und w[k+1] ≠ w[q]
6 do k ← \pi[k]
7 if w[k+1] = w[q]
8 then k ← k+1
9 \pi[q] ← k
10 return \pi | |
Das Ziel der Präfixfunktion ist es, für jedes Zeichen von w einen Wert \pi zu berechnen, der beim Matching aussagt, was die nächste Position ist, auf die das Wort verschoben werden soll. Die Demonstration geschieht an einem Beispiel.
Zuerst wird die Tabelle \pi für das Wort w=ababababca berechnet.
| i |
1 |
2 |
3 |
4 |
5 |
6 |
7 |
8 |
9 |
10 |
| w[i] |
a |
b |
a |
b |
a |
b |
a |
b |
c |
a |
| \pi[i] |
0 |
0 |
1 |
2 |
3 |
4 |
5 |
6 |
0 |
1 |
Jeder Wert \pi[i] gibt darüber Auskunft, um wie viele Stellen das Wort beim Suchen verschoben werden kann für den Fall, dass w[i+1] nicht mit t[j] (wobei 0<j<n) übereinstimmt oder w[m] = w[j] ist. Dabei berechnet sich die Verschiebung aus i-\pi[i]. Die Funktion gibt außerdem eine Auskunft über die Präfixeigenschaften des Wortes (wodurch sie auch zustande kommt). So ist w_{\pi[i]} ein Präfix von w_i.
Beispiel
Für die Suche des Wortes w im Text t=abababababcbababababca sehen die entscheidenden Schritte folgendermaßen aus:
| Position: | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 | 14 | 15 | 16 | 17 | 18 | 19 | 20 | 21 | 22 |
|---|
| Text: | a | b | a | b | a | b | a | b | a | b | c | b | a | b | a | b | a | b | a | b | c | a |
|---|
| Wort: | a | b | a | b | a | b | a | b | c | a | | | | | | | | | | | | |
|---|
| Position: | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 | 14 | 15 | 16 | 17 | 18 | 19 | 20 | 21 | 22 |
|---|
| Text: | a | b | a | b | a | b | a | b | a | b | c | b | a | b | a | b | a | b | a | b | c | a |
|---|
| Wort: | | | a | b | a | b | a | b | a | b | c | a | | | | | | | | | | |
|---|
| Position: | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 | 14 | 15 | 16 | 17 | 18 | 19 | 20 | 21 | 22 |
|---|
| Text: | a | b | a | b | a | b | a | b | a | b | c | b | a | b | a | b | a | b | a | b | c | a |
|---|
| Wort: | | | | | | | | | | | | a | b | a | b | a | b | a | b | c | a | |
|---|
| Position: | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 | 14 | 15 | 16 | 17 | 18 | 19 | 20 | 21 | 22 |
|---|
| Text: | a | b | a | b | a | b | a | b | a | b | c | b | a | b | a | b | a | b | a | b | c | a |
|---|
| Wort: | | | | | | | | | | | | | a | b | a | b | a | b | a | b | c | a |
|---|
Überblick aller Laufzeiten
Lösungen
Die Lösungen werden nach der Veranstaltung veröffentlicht.
Quellen
- Cormen, Thomas; Leiserson, Charles; Rivest, Ronald; Stein, Clifford: Algorithmen, eine Einführung,Oldenbourg Verlag, 2007
- Vöcking, Berthold: Taschenbuch der Algorithmen, Springer-Verlag, 2008

