String matching WS13-14

Aus ProgrammingWiki
< AuK
Archivierte Version vom 2014-01-17T01:43:42+00:00. Aktuelle Version

Inhaltsverzeichnis

Autor: Yevgeniy Oliynyk

Allgemeines und Festlegungen

String matching befasst sich allgemein mit dem Finden eines Wortes in einem Text.
Beim Text handelt es sich um eine endliche Folge von Zeichen (bestehend aus dem Alphabet \Sigma der Groß- und Kleinbuchstaben, Zahlen und Satzzeichen) und wird mit t abgekürzt. Das Wort setzt sich ebenfalls aus den selben Zeichen zusammen und wird abgekürzt als w dargestellt. Obwohl es aus mehreren Wörtern bestehen kann, wird es im Folgenden als "Wort" bezeichnet.
Sowohl der Text, als auch das Wort, weisen eine bestimmte Länge auf. Dies bezieht sich auf die Anzahl der Zeichen des Textes bzw. des Wortes. Beim Text wird die Länge mit n (bzw. |t|) bezeichnet und beim Wort mit m (bzw. |w|). Dabei gilt für jedes Text- und Wortpaar in den Beispielen der Seite folgende Vereinbarung: m \leq n.
Um nun festzustellen, ob sich ein Wort in einem Text befindet, müssen einzelne Zeichen verglichen werden. Deren Positionen werden folgedermaßen beschrieben:

  • das i-te Zeichen von t heißt t[i], wobei 1\leq i \leq n gilt
  • das j-te Zeichen von w heißt w[j], wobei 1\leq j \leq m gilt.

Somit ist eine präzise Positionsangabe möglich.
Der Standardtext für alle hier aufgeführten Beispiele lautet: Das ist das Haus vom Nikolaus mit n=29.

Ein naiver Algorithmus

Vorüberlegung

Um zu erfahren, ob sich das gesuchte Wort an einer beliebigen Stelle t[pos] (1 \leq pos \leq n-m+1) im Text befindet, muss ein Vergleich zwischen den Zeichen an der Stelle t[pos] und w[1] unternommen werden. Falls diese übereinstimmen, so wird weiter verglichen. Im nächsten Schritt wären es dann die Zeichen der Positionen t[pos+1] und w[2]. In der Art und Weise geht es weiter, bis entweder irgendwann 2 ungleiche Zeichen miteinander verglichen werden oder der Fall eintritt, dass auch die Zeichen an der Stelle t[pos+m-1] und w[m] überein stimmen. Das erstere bedeutet, dass das Wort nicht im Text an der gegebenen Position vorkommt. Das letztere hingegen würde eine Erfolgsmeldung nachsich ziehen.


Beispiele

 
Stelle 1 2 3 4 5 6 7 8 9 10 11 12
Text D a s i s t d a s
Wort D a s h c a m - - - - -
Vergleich ✓ ✓ ✓ x - - - - - - - -
Stelle 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19
Text D a s i s t d a s H a u s v o
Wort D a s i s t d a s H a u s - - -
Vergleich ✓ ✓ ✓ ✓ ✓ ✓ ✓ ✓ ✓ ✓ ✓ ✓ ✓ ✓ ✓ ✓ - - -
Beispiel 1 Beispiel 2

Programmbeispiel

Bisher wird aber nur eine Stelle im Text betrachtet. Um aber festzustellen, ob sich das Wort nicht nur an einer bstimmten Stelle befindet, sonder ob es an einer beliebigen Position vorkommt, ist eine Schleife nötig. Dadurch geht man Zeichen für Zeichen den Text durch und Vergleicht diesen mit dem Wort. Da es eine naive Methode ist, kann man ganz genau sagen, wie viele Schleifendurchläufe nötig sind, nämlich n-m+1. Als Ergebnis einer solchen Funktion, würde man alle Vorkommen des Wortes im Text und dessen Position als Ergebnis zurück bekommen. Sollte sich das Wort nicht im Text befinden, so bekommt man eine dementsprechende Antwort.

Ein passender Algorithmus dazu könnte wie folgt aussehen:

Laufzeitanalyse

Durch die Einfachheit des Algorithmus lässt sich eine Laufzeitanalyse wunderbar durchführen.

Das Best-Case-Szenario würde offensichtlich so aussehen, dass bei jedem Schleifendurchgang nur eine Vergleichsoperation durchgeführt wird. Dies wäre der Fall, wenn m=1 ist oder wenn das Zeichen w[1] nicht in t vorkommt. Somit ist die Laufzeit \mathcal{O}(n-m+1).

Im Worst-Case-Szenario gibt es den Fall, dass bei jeder Stelle des Textes, alle Zeichen des Wortes mit dem jeweiligen Zeichen des Textes verglichen werden müssen. Ein Beispiel für so einen Fall wäre


Stelle 1 2 3 4 5
Text a a a a a
Wort a a a - -
Vergleich ✓ ✓ ✓ - -
Stelle 1 2 3 4 5
Text a a a a a
Wort - a a a -
Vergleich - ✓ ✓ ✓ -
Stelle 1 2 3 4 5
Text a a a a a
Wort - - a a a
Vergleich - - ✓ ✓ ✓
Schritt 1 Schritt 2 Schritt 3

mit t=aaaaa und w=aaa. Somit sind wieder alle Schleifendurchläufe im Spiel und noch zusätzlich eine weitere Schleife, die in der bisheringen verschachtelt ist und die jedes mal von 1 bis m durchläuft. Der Zeitbedarf steigt auf \mathcal{O}((n-m+1)m). Dementsprechend arbeitet der Algorithmus insgesamt mit einem Aufwand in \mathcal{O}((n-m+1)m).
Bei geeigneter Wahl von t und w und deren längen (m = ⌊n/2⌋), liegt der Aufwand des Algorithmus sogar in \Theta(n^2).

Der Boyer-Moore-Horspool Algorithmus

Der BMH Algorithmus kann eine deutliche Effizienzsteigung gegenüber dem naiven Algorithmus aufweisen. Er wurde 1980 von Nigel Horspool veröffentlicht und stellt eine Vereinfachung des Boyer-Moore Algorithmus dar.

Idee

Im naiven Algorithmus hat man immer bei einer bestimmten Position im Text das Wort mit dem Textabschnitt von links aus verglichen. Im Grunde ist es aber egal, ob man von links oder von rechts mit dem Vergleichen beginnt, denn das spielt in dem Fall keine Rolle. Für BMH jedoch ist es essenziell, dass man von rechts aus mit dem Vergleich beginnt. Dies bringt denn folgenden Vorteil mit sich, dass man eine Art Vorhersage treffen kann. Denn das Ziel dieses Verfahrens ist es, nicht jedes Zeichen des Textes zu untersuchen und somit unnötige Operationen einzusparen, ohne dabei das Risiko einzugehen, dass man ein Vorkommen des Wortes im Text übersieht. Dies gelingt mit diesem Vorhersehen und durch eine vorherige Auswertung des Wortes. Dadurch wird es möglich bis zu m Stellen in Folge im Text auszulassen.

Beispiele


Stelle 11 12 13 14 15 16 17 18 19 20 21 22
Text s H a u s v o m N
Wort - - H u n d - - - - - -
Vergleich - - - - - x - - - - - -
Stelle 19 20 21 22 23 24 25 26 27 28 29
Text o m N i k o l a u s
Wort M i r k o - - - - - -
Vergleich - - - - x - - - - - -
Stelle 11 12 13 14 15 16 17 18 19 20 21 22
Text s H a u s v o m N
Wort - - - - - - H u n d - -
Vergleich - - - - - - - - - - - -
Stelle 19 20 21 22 23 24 25 26 27 28 29
Text o m N i k o l a u s
Wort - - - M i r k o - - -
Vergleich - - - - - - - - - - -
Beispiel 1: verschieben um 4 Stellen Beispiel 2: verschieben um 3 Stellen

Die Beispiele verdeutlichen in etwa, wie das System in etwa funktioniert. Nach dem eine Suche auf einer beliebigen pos im Text beendet wurde, wird geguckt, ob das Zeichen bei t[pos] im Wort vorkommt. Ist das der Fall, wird der Abstand a des Zeichens zum rechten Ende des Wortes genommen. a gibt an, um wie viele Positionen das Wort verschoben werden darf. Nach der Verschiebung stimmen t(pos+a) und w(m) überein. Sollte das Zeichen nicht in w vorkommen, dann wird w um m Stellen verschoben.
Die Abstandsberechnung wird typischerweise im Vorfeld durchgeführt.

Bad-Character

Bevor man mit dem Suchen des Wortes im Text beginnt, erstellt man eine Tabelle D mit allen möglichen Zeichen, die im Wort vorkommen dürfen (\Sigma). Jedem Zeichen wird ein bestimmter Wert zugeordnet, der später entscheidet, um wie viele Stellen das Wort verschoben werden darf. Dabei wird sinnvollerweise als erstes jedem Zeichen der Wert m zugewiesen. Danach geht man Zeichenweise von links nach rechts das Wort durch und trägt in die entsprechenden Felder den Abstand zum rechten Ende des Wortes ein. Das letzte Zeichen, also w[m], darf nicht mitberücksichtigt werden, da sonst a=0 wäre und D[w[m]]=0 verboten ist. Andernfalls würde der Algorithmus in einer Endlosschleife enden.

Beispiele für einige Tabellen D


Zeichen K a e t z
Wert 4 3 5 2 1
Zeichen e s t
Wert 2 4 1
Zeichen S a c d e h l n o p r
Wert 12 2 11 13 5 10 6 9 4 3 1
Beispiel 1: w = Katze Beispiel 2: w = stets Beispiel 2: w = Schneeleopard

In den Beispielen wurden übersichtshalber nur Zeichen berücksichtigt, die im Wort enthalten sind. Allen anderen ist der Wert m zugewiesen. Außerdem sind sie praktischerweise nach dem Vorkommen in der ASCII-Tabelle sortiert.


Programmbeispiel

Laufzeitanalyse

Obwohl auch hier beim Worst-Case-Szenario der Algorithmus die selben Probleme aufweißt wie der naive Algorithmus, ist dieser Algorithmus im Mittel jedoch viel schneller bei der Abarbeitung. Vor allem, wenn es sich um einen gewöhnlichen Text handelt. Dies kann sehr gut dadurch veranschauligt werden, dass bei dem Algorithmus die Möglichkeit besteht, unnötiges Suchen an Stellen, wo niemals das Wort vorkommen kann, zu vermeiden. Doch um diesen Vorteil ausnutzen zu können, muss davor D berechnet werden. Der Aufwand liegt dabei in \mathcal{O}(m). Nach dieser einmaligen Vorverarbeitung arbeitet der eigentliche Suchalgorithmus in \mathcal{O}(n) (im Average-Case) und ist somit potenziell deutlich schneller als das naive Verfahren.

Weitere Algorithmen

String-Matching mit endlichen Automaten

Es gibt viele Wortsuchalgorithmen, die mit Hilfe von endlichen Automaten arbeiten. Eins davon wird hier vorgestellt.
Die Motivation dahinter ist die Effizienz eines solchen Algorithmus. Bei der Suche nach einem Wort (in dem Zusammenhang auch Muster bzw. pattern genannt) wird jedes Textzeichen nur ein einziges mal untersucht. Diese Untersuchung benötigt, anders als bei den vorherigen Verfahren, stets eine konstante Zeit. Somit schafft es der Algorithmus einen Aufwand zu erreichen, der in \Theta(n) liegt, wenn man nur die Matchingzeit betrachtet.

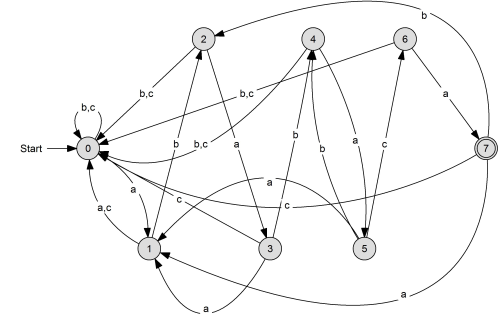
Für die Veranschaulichung wird ein DEA mit M = (Q,\Sigma , q_0 , E, \delta ) verwendet. Dabei ist das Eingabealphabet \Sigma nichts weiter als das am Anfang unter Allgemeines und Festlegungen festgelegte Alphabet und besteht demzufolge aus den selben Elementen. Da das Wort entscheidend für die Gestaltung des Automaten ist und nicht der Text, besitzt der Automat m+1 Zustände: Q = \{ 0,1,2,...,m-1,m\} , wobei q_0 = 0 ist. Es gibt nur einen Endzustand, nämlich A = \{ m\} . Diesen gilt es zu erreichen, damit M das Signal geben kann, dass das Wort im Eingabetext des Automaten gefunden wurde. Jetzt fehlt nur noch die Übergangsfunktion \delta, die ein Wort im Text erkennen soll. Um diese Übergangsfunktion aufzustellen, gibt es eine Vorschrift.


Vorschrift

Compute-Transition-Function(w,\Sigma)

1 m ← länge[w]

2 for q ← 0 to m
3   do for jedes Zeichen a \in \Sigma 
4     do k ← min(m+1,q+2) 
5       repeate k ← k - 1
6         until w_k \sqsupset w_q a
7       \delta (q,a) ← k
8 return \delta 
Bemerkung

Die Schleifen, die in Zeile 2 und 3 beginnen, betrachten alle Zustände in Kombination mit allen Zeichen. Ziel der Funktion ist es den Folgezustand k zu ermitteln, der in Zeile 7 in eine Übergangstabelle \delta(q,a) in das jeweilige Feld eingetragen wird. w_k steht für das Wort, das aber nur bis zur k-ten Stelle betrachtet wird und w_q a ist das selbe wie a an w_{k-1} angehängt.


Eugen_DEA.jpg
DEA für w = ababaca

Beispiel

M = (Q,\Sigma , q_0 , E, \delta ), mit

  • Q = \{ 0,1,2,3,4,5,6,7\}
  • \Sigma = \{ a,b,c\}
  • q_0 = 0
  • E = \{ 7\}
  • \delta

Eugen_White.jpg

Der Knuth-Morris-Pratt-Algorithmus

Obwohl die Suche beim endlichen Automaten eine akzeptable Laufzeit ausweist, stellt die Vorverarbeitung und damit die Berechnung der Überführungsfunktion mit einem Aufwand in \Theta(m |\Sigma|) ein Hindernis dar. Eine vielversprechende Lösung bietet der KMP Algorithmus. Statt der \delta wird eine Hilfsfunktion \pi (auch Feld genannt) zum Einsatz für die Vorberechnung kommt. Deren Aufwand liegt in nur \Theta(m). Das Matching selber ist vom Aufwand her der selbe, wie schon mit endlichen Automaten.

KMP-Matching-Algorithmus

KMP-Matcher(t,w)

1 n ← länge[t]

 2  m ← länge[w]
 3  \pi ←Compute-Prefix-Function(w)
 4  q ← 0
 5  for i ← 1 to n
 6      do while q > 0 und w[q+1] ≠ t[i]
 7          do q ← \pi[q]
 8        if w[q+1] = t[i]
 9          then q ← q+1
10        if q=m
11          then print "Das Wort tritt mit der Verschiebung" i-m "auf"
12            q ← \pi[q]


Compute-Prefix-Function(w)

1 m ← länge[w]

 2  \pi[1] ← 0
 3  k ← 0
 4  for q ← 2 to m
 5      do while k>0 und w[k+1] ≠ w[q]
 6          do k ← \pi[k]
 7        if w[k+1] = w[q]
 8          then k ← k+1
 9        \pi[q] ← k
10  return \pi


Das Ziel der Präfixfunktion ist es, für jedes Zeichen von w einen Wert \pi zu berechnen, der beim Matching aussagt, was die nächste Position ist, auf die das Wort verschoben werden soll. Die Demonstration geschieht an einem Beispiel

Zuerst wird die Tabelle \pi für das Wort w=ababababca berechnet.

     
i 1 2 3 4 5 6 7 8 9 10
w[i] a b a b a b a b c a
\pi[i] 0 0 1 2 3 4 5 6 0 1


Jeder Wert \pi[i] gibt darüber Auskunft, um wie viele Stellen das Wort beim Suchen verschoben werden kann für den Fall, dass w[i] nicht mit t[j] (wobei 0<j<n) übereinstimmt oder w[m] = w[j] ist. Dabei berechnet sich die Verschiebung aus i-\pi[i]. Die Funktion gibt außerdem eine Auskunft über die Präfixeigenschaften des Wortes (wodurch sie auch zustande kommt). So ist w_{\pi[i]} ein Präfix von w_i.

Bemerkung

Falls \pi[i]=0 und somit w_{\pi[i]} = w_0, ergibt sich ein Wort der Länge 0, also ein Wort ohne Zeichen. Dieses Wort ist automatisch ein Präfix von allen beliebigen Wörtern. Somit ist die Aussage, dass w_{pi[i]} ein Präfix von w_i ist, in dem Bezug allgemeingültig.

Für die Suche des Wortes w im Text t=abababababcbababababca sehen die entscheidenden Schritte folgendermaßen aus:

Position:12345678910111213141516171819202122
Text:abababababcbababababca
Wort:ababababca
Position:12345678910111213141516171819202122
Text:abababababcbababababca
Wort:ababababca
Position:12345678910111213141516171819202122
Text:abababababcbababababca
Wort:ababababca
Position:12345678910111213141516171819202122
Text:abababababcbababababca
Wort:ababababca
Position:12345678910111213141516171819202122
Text:abababababcbababababca
Wort:ababababca
Position:12345678910111213141516171819202122
Text:abababababcbababababca
Wort:ababababca