Durchläufe durch Graphen SS12
Inhaltsverzeichnis |
Der Graphendurchlauf (engl. graph traversal) bildet die Grundlage vieler Graphenalgorithmen. Die Idee besteht darin, alle Knoten bzw. Kanten in einem Graphen systematisch zu besuchen, um beispielsweise Informationen über dessen Struktur zu sammeln.
[[Bild:Croxeldyffic_Labyrinth03.png|thumb|200px|right|Ein Labyrinth mit Startpunkt (grün) und Ziel (rot) (Animation)]]Als Motivation für die Lösung dieses Problems soll folgendes Beispiel dienen: Eine Person befindet sich in einem Labyrinth, und sucht einen Ausgang, indem sie alle möglichen Kreuzungen von Gängen in Augenschein nimmt. Übertragen auf die Graphentheorie, existieren hierfür zwei bekannte algorithmische Lösungsverfahren, die Hauptgegenstand dieser Vorlesung sind. In unserem Beispiel sind die Gänge des Labyrinths die Kanten und alle Kreuzugen die Knoten des Graphen.
Stellen wir uns vor, die eingeschlossene Person folgt einem bestimmten Gang solange, bis sie in eine Sackgasse gerät, zur letzten Kreuzung zurückkehrt und einem anderen Weg auf die gleiche Art verfolgt. Dieses systematische Vordringen in die "Tiefe" nennen wir Tiefensuche. Sucht jedoch eine Gruppe von Leuten den Ausgang, so ist es wahrscheinlicher, dass sie gemeinsam vom Startpunkt ausschwärmen in die "Breite" vordringen. Analog dazu sprechen wir von einer Breitensuche.
Am Ende des Kapitels wird es uns möglich sein, das Labyrinth-Problem und viele andere graphentheoretische Probleme mithilfe der beiden Algorithmen zu lösen.
Hinweis: Im Folgenden wird häufig von Suche die Rede sein, obwohl es sich meistens eher um einen Durchlauf handelt. Durch die Übernahme der englischen Begrifflichkeiten DFS und BFS (depth-first und breadth-first search) haben sich die Bezeichnungen Tiefen- und Breitensuche anstelle von -durchlauf eingebürgert. Wir hoffen, damit kein allzu große Verwirrung zu stiften.
TODO-Pic:
// suchbäume dfs & bfs
// hamilton
// SCC - bsp-graph + lösung
Applets:
// bfs/dfs-applet: http://www.cosc.canterbury.ac.nz/mukundan/dsal/GraphAppl.html meh~
// dfs-applet: http://www.lupinho.net/lupinho.de/gishur/html/DFSApplet.html w00ts~
// bfs-applet: http://www.lupinho.net/lupinho.de/gishur/html/BFSApplet.html w00ts2x~
// eu/hm-applets zum knobeln: http://www.cut-the-knot.org/Curriculum/Combinatorics/GraphPractice.shtml spiffy~
// laby-applet: http://www.swisseduc.ch/informatik/diskrete_mathematik/tiefensuche_labyrinth/applet.html lolz~
Wiederholung
Zum Verständnis der später vorgestellten Graphenalgorithmen sind grundlegende Kenntnisse über Graphen und spezielle Datenstrukturen notwendig, die jedoch bereits Themen in vorigen Veranstaltungen waren und im Folgenden nur aufgefrischt werden sollen.
Graphrepräsentation
\rightarrow siehe Vorlesung Graphrepräsentation
Kontrollfragen:
- Was ist der Unterschied zwischen gerichteten und ungerichteten Graphen?
Lösung
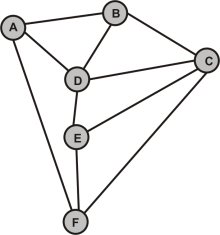 Ein ungerichteter Graph
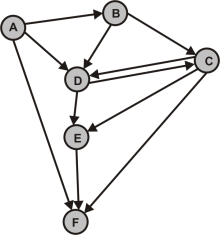 Ein gerichteter Graph
In einem ungerichteten Graphen kann eine Kante (u,v) in beliebiger Richtung überquert werden, während in einem gerichteten Graphen die zulässige Durchlaufrichtung durch einen Pfeil gekennzeichnet ist (ähnlich einer Einbahnstraße).
Will man einen ungerichteten Graphen gerichtet darstellen, so verdoppelt sich die Kantenmenge, d.h. enthält die Kantenmenge K des ungerichteten Graphen die Kante (u,v), muss die Kantenmenge K des gerichteten Graphen die Kanten (u,v) und (v,u) enthalten.
- Welche Darstellungsformen für Graphen gibt es?
- Wie können diese im Computer realisiert werden?
- Welche ist am besten?
Lösung
-
- Feld: Ein Adjazenzfeld ist eine sehr einfache Darstellungsform, in der alle Zielknoten in einem Array geordnet nach Startknoten gespeichert werden.
- Liste: Eine Adjazenzliste ist eine verkettete Liste mit Nachfolgern bzw. Nachbar eines Knotens.
- Matrix: Eine Adjazenzmatrix ist ein mehrdimensionales (V \times V mit V als Knotenanzahl) Array mit booleschen Variablen, in der a[u,v] auf 1 oder true gesetzt wird, wenn eine Kante (u,v) existiert. Analog dazu gibt eine Inzidenzmatrix (V \times E-großes Array) die Inzidenzbeziehungen zwischen Knoten und Kanten in einem Graphen an.
- Wir vergleichen die drei bzw. vier Darstellungsformen miteinander:
     Adjazenzfeld
     Adjazenzliste
     Adjazenzmatrix
     Inzidenzmatrix
Speicheraufwand \mathcal{O}\: (|V| + |E|) \mathcal{O}\: (|V| + |E|) \mathcal{O}\: (|V|^2) \mathcal{O}\: (|V| \cdot |E|) Nachbarabfrage \mathcal{O}\: (d)^*
* d = max. Ausgangsgrad\mathcal{O}\: (d)^*
* d = max. Ausgangsgrad\mathcal{O}\: (1) \mathcal{O}\: (|E|) Vorteile + kompakte Darstellung + kompakte Darstellung
+ effizient für dynamische Graphen+ schneller Zugriff
+ effizient bei dichten Graphen
+ schnelles Löschen von Kanten+ besser bei lichten Graphen Nachteile - nur für statische Graphen - ineffizient für dichte Graphen - hoher Speicheraufwand
- ineffizient bei lichten Graphen- hoher Speicheraufwand bei dichten Graphen
- langsames Löschen von KantenFazit: Die Anzahl der Kanten ist bei den meisten Graphen höher als die Knotenanzahl, daher ist aufgrund der schnellen Zugriffszeit die Adjazenzmatrix als Darstellungsform empfohlen.


Bäume
\rightarrow siehe Vorlesung Sortierte Folgen
Kontrollfragen:
- Was sind die Bestandteile eines Baumes?
- Welche Arten von Knoten gibt es?
- Was ist ein Pfad?
Lösung
-
- Wurzelknoten: Der Startknoten, von dem alle Pfade ausgehen.
- Kindknoten: Der Nachfolger eines Knotens.
- Vaterknoten: Der Vorgänger eines Knotens. Die Wurzel eines Baumes besitzt keinen Vater.
- Geschwister- bzw. Bruderknoten: Knoten mit dem gleichen Vater.
- Blattknoten: Knoten ohne Nachfolger (Kinder).
- Ein Pfad entspricht einem Weg von einem Knoten zum anderen. In Bäumen sind meist Pfade, die von der Wurzel ausgehen, gesucht.
Datenstrukturen Stack und Queue
\rightarrow siehe Vorlesung Prioritätswarteschlangen
Kontrollfragen:
- Nach welchem Prinzip arbeitet eine Warteschlange?
Lösung
Eine Warteschlange (engl. queue) arbeitet nach dem FIFO-Prinzip, d.h. das Element, das zuerst in die Warteschlange abgelegt wurde, wird zuerst bearbeitet (ähnlich einer Schlange im Supermarkt).
Folgende Operationen sind notwendig:
- Element hinzufügen (enqueue): Das Element wird nach dem letzten Element eingefügt.
- erstes Element anzeigen (peek): Das zuerst hinzugefügte Element wird ausgegeben.
- Element löschen (dequeue): Das zuerst hinzugefügte Element wird ausgegeben und aus der Schlange entfernt.
- Prüfung, ob Schlange leer ist (isEmpty)
Implementierung:
- Nach welchem Prinzip arbeitet ein Stack?
- Element hinzufügen (push): Das Element wird an erster Stelle eingefügt.
- erstes Element anzeigen (peek): Das zuletzt hinzugefügte Element wird ausgegeben.
- Element löschen (pop): Das zuletzt hinzugefügte Element wird ausgegeben und aus dem Stack entfernt.
- Prüfung, ob Stack leer ist (isEmpty)
Lösung
Im Gegensatz zur Warteschlange arbeitet ein Stack nach dem LIFO-Prinzip, d.h. das Element, das zuletzt auf den Stack abgelegt wurde, wird zuerst bearbeitet (ähnlich einem Stapel Bücher etc.).
Folgende Operationen sind notwendig:
Implementierung:
Grundlagen zum Graphendurchlauf
Allgemeiner Durchlauf-Algorithmus
Unsere zentrale Frage lautet: Wie können wir die Knoten eines Graphen durchlaufen, sodass jeder Knoten mindestens einmal besucht wird?
Um am Ende eine vernünftige Durchlaufordnung angeben zu können, überlegen wir uns folgendes Verfahren:
- zusammenhängender Graph G als Adjazenzlisten- oder -matrixdarstellung
- eine Menge von Knoten v \in V mit den Zuständen unbesucht und besucht
- eine Arbeitsliste L, die besuchte aber noch nicht abgearbeitete Knoten beinhaltet.
- Initialisierung: nur der Startknoten v ist mit besucht markiert und befindet sich in der Arbeitsliste L
- solange L nicht leer ist:
- wähle einen Knoten v aus L
- wähle und markiere einen unbesuchten Nachbarn u von v als besucht und speichere u in die Arbeitsliste L
- falls v keine unbesuchten Nachbarn besitzt, entferne v aus L
Algorithmus: Graphendurchlauf_allgemein (Graph G, Knoten v \in V(G), Arbeitsliste L)
\begin{array}{l|l}
1 & v \leftarrow besucht\\
2 & L \leftarrow L \oplus v\\
3 & \mathbf{while}\; (L \neq\: \emptyset)\; \mathbf{do} \\
4 &\;\;\;\;\; \text{\small waehle Knoten } v \in L \\
5 &\;\;\;\;\;\; \mathbf{if}\; (\!\text{\small es gibt } u \in V(G) \text{\small mit } u=Nachbar\; von\; v \text{\small und } u=unbesucht)\; \mathbf{then} \\
6 &\;\;\;\;\;\;\;\;\;\;\;\; u \leftarrow besucht\\
7 &\;\;\;\;\;\;\;\;\;\;\;\; L \leftarrow L \oplus u\\
8 &\;\;\;\;\;\; \mathbf{else}\; L \leftarrow L \ominus u \\
\end{array}
end Graphendurchlauf_allgemein
Suchen wir im Graphen dagegen ein bestimmtes Element, so wie wir bei unserem Labyrinth-Problem nach dem Ausgang (Zielknoten) suchen, genügt es, den Algorithmus bis zum Auffinden des gesuchten Elements auszuführen und mit Ausgabe des Pfades bis zum Ziel terminieren zu lassen. Nachdem wir also das Ziel erreicht haben, ist es nicht nötig, den Graphen weiter zu durchlaufen, selbst wenn es noch unbesuchte Knoten gibt. Der Suchalgorithmus terminiert spätestens, wenn alle Knoten durchlaufen wurden, sodass sicher ist, dass das Element, falls es im Graphen enthalten ist, auch gefunden wird. In der Praxis ist diese Bedingung abhängig vom gewählten Verfahren nicht immer erfüllbar. Mehr dazu in den Abschnitten Breiten- und Tiefensuche.
Die Arbeitsliste L
Die Art und Weise wie die einzelnen besuchten Knoten in die Arbeitsliste L eingefügt werden sollen, ist beim Graphendurchlauf von großer Bedeutung. Hierfür gibt es zwei Möglichkeiten.
Die Arbeitsliste als Stack
Wird die Arbeitsliste als Stack implementiert, wird jeder besuchte Knoten nach dem LIFO-Prinzip eines Stacks auf L abgelegt.
Arbeitsweise:
- markiere den Startknoten v als besucht und legen ihn auf den leeren Stack ab
- solange der Stack nicht leer ist:
- ermittle alle unbesuchten Nachbarn des obersten Knotens v im Stack und lege sie auf den Stack ab
- falls der oberste Knoten keine unbesuchten Nachbarn besitzt, entferne ihn aus dem Stack und fahre mit dem neuen ersten Element fort.
Mit dieser Implementierung lässt sich die Tiefensuche realisieren.
Die Arbeitsliste als Queue

Wird die Arbeitsliste dagegen als Queue implementiert, werden die besuchten Knoten nach dem FIFO-Prinzip einer Warteschlange an L angefügt.
Arbeitsweise:
- markiere den Startknoten v als besucht und füge ihn in die leere Queue ein
- solange die Queue nicht leer ist:
- ermittle alle unbesuchten Nachbarn des ersten Knotens v in der Queue und hänge sie an die Warteschlange an
- falls v keine unbesuchten Nachbarn besitzt, entferne v aus der Queue und fahre mit dem neuen ersten Element fort
Mit dieser Implementation kann die Breitensuche realisiert werden.
Laufzeitverhalten
Mit welcher Laufzeit kann bei diesem Algorithmus gerechnet werden?
Relevant für den Algorithmus ist die Anzahl der Knoten und Kanten im Graphen. Daher ist die vom Verfahren benötigte Zeit ungeachtet der verwendeten Datenstruktur für die Arbeitsliste L stets proportional zur Summe der Anzahl aller vom Startknoten erreichbaren Knoten und Kanten. Der Schleifendurchlauf im Funktionskörper führt stets gleich viele Schritte aus, wobei kein Knoten doppelt abgearbeitet wird. Wir notieren eine Maximallaufzeit von \mathcal{O}\: (|V| + |E|) mit V als Knoten- und E als Kantenanzahl.
Zusammenhängende Graphen
Als Eingabe für den Durchlauf-Algorithmus haben wird einen zusammenhängenden Graphen angegeben. Wir fragen jetzt, wann ist ein Graph zusammenhängend bzw. was ist er es nicht?
Definition: Ein Graph G heißt zusammenhängend, wenn je zwei Knoten von G verbindbar sind, d.h. es existiert ein Kantezug (Pfad) zwischen den beiden Knoten. Ein zusammenhängender Graph enthält keine isolierten Knoten.
Beispiele:


Ein Anwendungsbeispiel zur Zusammenhangsproblematik findet sich in vielen Städten: Einbahnstraßen. Befinden sich in einem Stadtteil besonders viele Einbahnstraßen, stellt sich als Autofahrer die Frage, ob man noch von jedem Ort aus jeden anderen Ort erreichen kann.
Ist ein Graph nicht zusammenhängend, kann man ihn in gewisse Komponenten (Teilgraphen) zerlegen, die unter sich zusammenhängend sind. Die Menge dieser Teilgraphen ergibt widerum den Graphen. Wir sprechen hier bei ungerichteten Graphen von sogenannten Zusammenhangskomponenten und bei gerichteten Graphen von starken Zusammenhangskomponenten (engl. strongly connected components, SCCs), deren Bestimmung wir an späterer Stelle kennenlernen werden. Besteht ein Graph aus nur einer Zusammenhangskomponenten, ist er zusammenhängend.
Unsere interne Graphenrepräsentation
Eine Vielzahl der nachfolgenden Algorithmen wollen wir einerseits durch Rechnung per Hand als auch mittels Computer umsetzen und anwenden. Der Vorteil hierfür liegt vorallem bei Berechnungen und Operationen auf sehr umfangreichen und dichten Graphen. Wir verwenden in allen Programmbeispielen auschschließlich die Programmiersprache JAVA, da wir mithilfe der Objektorientierung die einzelnen Sachverhalte einfach und verständlich modellieren können.
Knoten
Graph
Einige der in der Klassendefinition von Graph enthaltenen Methoden sollen an dieser Stelle nun getestet werden. Wir erstellen zwei Beispielgraphen jeweils unterschiedlichen Typs und mit unterschiedlicher Knoten- und Kantenanzahl. Des Weiteren lassen wir uns die zugehörigen Adjazenzmatrizen anzeigen.
Übungsaufgaben:
- Zeichnen Sie die beiden Graphen G_{bsp01} und G_{bsp02} per Hand.
- Sind beide Graphen zusammenhängend?
Lösung
- mögliche Anordnung der Knoten:
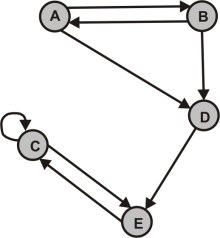 Digraph $G_{bsp01}$
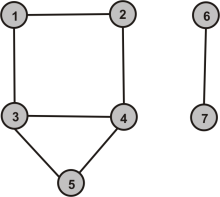 Ungerichteter Graph $G_{bsp02}$
- Graph G_{bsp01} ist nur ein schwach zusammenhängender Digraph, d.h. er ist zusammenhängend, wenn man ihn in einen ungerichteten Graphen umwandelt. Graph G_{bsp02} einen unzusammenhängenden, ungerichteten Graphen repräsentiert.


Tiefensuche

Die Tiefensuche beginnt mit einem beliebigen Startknoten u \in V(G) und folgt einer mit u adjazenten Kante, bis zum nächsten Knoten v\in V(G) der noch nicht besucht wurde(unmarkiert ist). Von diesem aus wird wieder ein erreichbarer Knoten gesucht. Man folgt also solange einem Kantenzug, bis man ein Blatt erreicht hat. Alle dabei entdeckten Knoten werden markiert.
Nun verfolgt man den entstandenen Kantenzug solange zurück(backtracing), bis man einen Knoten findet, mit dem noch unbesuchte Knoten verbunden sind. Wird solch ein Knoten entdeckt, wählt man ihn als neuen Startknoten und folgt wieder seinen adjazenten Kanten.
Anschließend wird solange ein neuer unmarkierter Knoten als Startknoten gewählt und abgearbeitet, bis alle Knoten markiert sind.
Auf diese Weise entsteht ein Suchwald. Obwohl der Algorithmus einen Graphen G immer vollständig abarbeitet, können abhänig vom Startknoten und der konkreten Implementierung verschiedene Suchwälder entstehen. Meistens ist aber jeder Wald sinnvoll verwendbar.
Iterativ mit Stack
Nur für zusammenhängende Graphen und bei manchen Graphen unvollständig
Algorithmus: Tiefendurchlauf (Graph G, Knoten v \in V(G), Stack S)
\begin{array}{l|l}
1 & v \leftarrow besucht\\
2 & S \leftarrow push(v)\\
3 & \mathbf{while}\; (S \neq\: \emptyset)\; \mathbf{do} \\
4 &\;\;\;\;\; \text{\small waehle Knoten } v \in S \text{\small mit } v = peek(S) \\
5 &\;\;\;\;\;\; \mathbf{if}\; (\!\text{\small es gibt } u \in V(G) \text{\small mit } u=Nachbar\; von\; v \text{\small und } u=unbesucht)\; \mathbf{then} \\
6 &\;\;\;\;\;\;\;\;\;\;\;\; u \leftarrow besucht\\
7 &\;\;\;\;\;\;\;\;\;\;\;\; S \leftarrow push(u)\\
8 &\;\;\;\;\;\; \mathbf{else}\; S \leftarrow pop(u) \\
\end{array}
end Tiefendurchlauf
Rekursive DFS

- Eingaben:
- Graph G als Adjazenzlisten- oder -matrixdarstellung
- Eine Menge von Knoten V(G)mit den Zuständen:
- farbe=weiss für unbesuchte Knoten
- farbe=grau für besuchte Knoten
- farbe=schwarz für abgeschlossene Knoten
- \pi=nil (der Vorgänger)
- d[u]=0 (die Zeit der Entdeckung)
- f[u]=0 (die Zeit des Abschließens)
Algorithmus: DFSrek (Graph G)
\begin{array}{l|l} 1 & \mathbf{for}\; alle Knoten\; u\in V(G)\\ 2 &\;\;\;\;\; \mathbf{do} farbe[u] \leftarrow weiss\\ 3 &\;\;\;\;\; \pi[u] \leftarrow NIL\\ 4 & zeit \leftarrow 0\\ 5 & \mathbf{for}\; alle Knoten\; u\in V(G)\\ 6 &\;\;\;\;\; \mathbf{do}\;\mathbf{if}\; farbe[u] = weiss\\ 7 &\;\;\;\;\;\;\;\;\;\;\;\mathbf{then} \;DFSvisit(u)\\ \end{array}
end DFSrekAlgorithmus: DFSvisit (u)
\begin{array}{l|l} 1 & farbe[u] \leftarrow grau\\ 2 & zeit \leftarrow zeit+1\\ 3 & \pi[u] \leftarrow zeit\\ 4 & \mathbf{for}\; alle\; v \in Adj(u)\\ 5 & \;\;\;\;\; \mathbf{do}\;\mathbf{if}\; farbe[v] = weiss\\ 6 & \;\;\;\;\;\;\;\;\;\;\;\mathbf{then} \;\pi[v] \leftarrow u\\ 7 & \;\;\;\;\;\;\;\;\;\;\;\;\;\;\;\;\ DFSvisit(v)\\ 8 & farbe[u] \leftarrow schwarz\\ 9 & f[u] \leftarrow zeit \leftarrow zeit+1\\ \end{array}
end DFSvisit
Funktion
1 |
public void dfsrek((int start, (char c) {
System.out.println( "\n\nDFS-Durchlaufordnung(rekursiv): ");
start--;
for (int j=0; j<knoten j knotenliste color="#00F"><b> "weiss"</b>;
knotenliste[j].prev = null;
}
zeit = 0;
<font color="#C92120"><b>for</b></font> (<font color="#C92120"><b>int</b></font> j=start; j<knoten j color="#C92120"><b>if</b> (knotenliste[j].farbe == <font color="#00F"><b> "weiss"</b></font>)
dfsvisit(j, c);
}
<font color="#C92120"><b>if</b></font> (start != 0)
<font color="#C92120"><b>for</b></font> (<font color="#C92120"><b>int</b></font> j = 0; j < start; j++) {
<font color="#C92120"><b>if</b></font> (knotenliste[j].farbe == <font color="#00F"><b> "weiss"</b></font>)
dfsvisit(j, c);
};
<font color="#C92120"><b>for</b></font>(<font color="#C92120"><b>int</b></font> j=0; j<knoten j displayvertex color="#00F"><b> "erweitert"</b>);
System.out.println();
};
}</knoten></knoten></knoten> public void dfsvisit(int u, char c)
{
knotenliste[u].farbe = "grau";
zeit++;
knotenliste[u].gefunden = zeit;
if (knotenliste[u].label == c)
System.out.println(c + " in Schritt " + knotenliste[u].gefunden + " gefunden\n");
for (int j=0; j<knoten j color="#C92120"><b>if</b> (adjazenzMatrix[u][j] == 1 && knotenliste[j].farbe == <font color="#00F"><b> "weiss"</b></font>) {
knotenliste[j].prev = knotenliste[u];
dfsvisit(j, c);}
knotenliste[u].farbe = <font color="#00F"><b> "schwarz"</b></font>;
zeit++;
knotenliste[u].abgearbeitet = zeit;
topologie.push(u + 1);
}</knoten>} |
Klassifizierung der Kanten
Wie schon beschrieben erzeugt die DFS einen vom Durchlauf abhängigen Tiefensuchwald. Man kann nun jede Kante einem von vier Typen zuordnen, entsprechend ihrer Sondierung in der DFS
- Typen:
- Baumkanten sind Kanten im Tiefensuchwald G_\pi . Kante (u,v) ist eine Baumkante, falls v bei der Sondierung der Kante (u,v) entdeckt wurde
- Rückwärtskanten sind Kanten (u,v), die u mit einem Vorfahren v im Tiefensuchbaum verbinden. Ebenso Schlingen in gerichteten Graphen
- Vorwärtskanten sind alle nicht-Baumkanten (u,v) die u mit einem Nachfahren v im Tiefensuchbaum verbinden
- Querkanten sind alle verbliebenen Kanten, solange nicht der eine Vorfahre des anderen ist
Breitensuche

Während die Tiefensuche zunächst einem Pfad bis zur nächsten Sackgasse folgt und dabei recht unbalancierte Suchwälder erzeugt, kommt die Breiten einem vorsichtigerem Voranschreiten gleich. Bevor das Verfahren einen weiteren Schritt in die Tiefe unternimmt, werden zunächst alle Knoten auf der momentanen Ebene (engl. Layer) besucht. Von einem Startknoten v werden also zunächst alle Knoten mit dem Abstand d(v)=1, d.h. alle unmittelbaren Nachbarknoten untersucht und in den nächsten Schritten jeweils alle Knoten mit dem Abstand d+1, d.h. alle Nachfolger der Nachfolger.
Dieses schichtweise Voranschreiten hat mehrere Vorteile gegenüber der Tiefensuche:
- Es werden ausbalancierte Suchwälder erzeugt.
- Es wird immer der kürzeste Weg von einem Knoten zum nächsten gefunden.
- Es wird sichergestellt, dass das Verfahren mit Sicherheit bei einer Knotensuche terminiert, falls sich das gesuchte Element im Graphen befinden sollte. Bei der Tiefensuche kann es dagegen passieren, bei Zyklen eine Endlosschleife zu produzieren, falls man bei der Implementation das Auftreten von Kreisen nicht berücksichtigt.
Um alle Knoten in einem Graphen zu durchlaufen, benötigt die Breitensuche jedoch im Allgemeinen mehr Schritte, also einen höheren Speicherbedarf, als die Tiefensuche, besitzt aber dennoch die Komplexität \mathcal{O}\: (|V| + |E|).
Abgeleitet von der allgemeinen Durchlaufvorschrift unter Benutzung einer Warteschlange Q als Arbeitsliste, beschreibt folgender Algorithmus die Arbeitsweise der Breitensuche.
Algorithmus: Breitendurchlauf (Graph G, Knoten v \in V(G), Queue Q)
\begin{array}{l|l}
1 & v \leftarrow besucht\\
2 & Q \leftarrow enqueue(v)\\
3 & \mathbf{while}\; (Q \neq\: \emptyset)\; \mathbf{do} \\
4 &\;\;\;\;\; \text{\small waehle Knoten } v \in Q \text{\small mit } v = peek(Q) \\
5 &\;\;\;\;\;\; \mathbf{if}\; (\!\text{\small es gibt } u \in V(G) \text{\small mit } u=Nachbar\; von\; v \text{\small und } u=unbesucht)\; \mathbf{then} \\
6 &\;\;\;\;\;\;\;\;\;\;\;\; u \leftarrow besucht\\
7 &\;\;\;\;\;\;\;\;\;\;\;\; Q \leftarrow enqueue(u)\\
8 &\;\;\;\;\;\; \mathbf{else}\; Q \leftarrow dequeue(u) \\
\end{array}
end Breitendurchlauf
Der Algorithmus kann aufgrund seiner klaren Struktur sehr einfach in Programmcode übertragen werden. Wie wir bereits bei der DFS-Implementierung mit Stack bemerkt haben, können wir mit diesem Algorithmus nur zusammenhängende Graphen durchlaufen.
Funktion
1 |
public void bfs (int start) { System.out.println( "BFS-Durchlaufordnung:" );
start--;
knotenliste[start].bereitsBesucht = true;
displayVertex(start);
theQueue.enqueue(start);
while ( !theQueue.istLeer() )
{
int v = naechsterUnbesuchterNachbar( theQueue.peek() );
if (v == -1)
theQueue.dequeue();
else
{
knotenliste[v].bereitsBesucht = true;
displayVertex(v);
theQueue.enqueue(v);
}
}
for(int i=0; i<knotenanzahl color="#C92120"><b>if</b>(knotenliste[i].bereitsBesucht==false){
System.out.println(<font color="#00F"><b>"... Graph nicht zusammenhängend!"</b></font>);
break;}
<font color="#C92120"><b>else</b></font> continue;
}
<font color="#C92120"><b>for</b></font>(<font color="#C92120"><b>int</b></font> j=0; j<knotenanzahl j knotenliste false><p>}</p></knotenanzahl></knotenanzahl> |
Übungsaufgaben:
- Durchlaufen Sie die folgenden Graphen jeweils vom Knoten 1 zunächst per Hand und überprüfen Sie Ihre Lösung anschließend mit dem Programm.
- G_1
- G_2 (Was fällt bei diesem Graphen auf? Interpretieren Sie die Programmausgabe.)
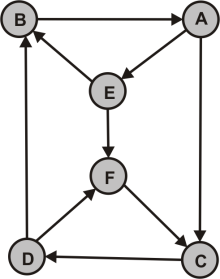 $G_1$
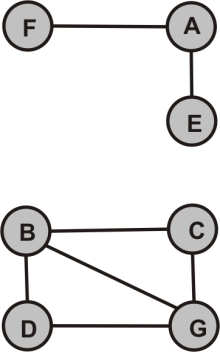 $G_2$
- Testen Sie das BFS-Applet auf: Lupinho.de mit
- einem gerichteten Graphen.
- einen unzusammenhängenden Graphen.
Hilfe zu Bedienung des Applet erhalten Sie hier.
Kombination von Tiefen- und Breitensuche
Beide Durchlaufverfahren haben ihre Vor- und Nachteile und sind je nach Problemstellung günstig. Nachfolgend seien nochmals Tiefen- und Breitensuche gegenübergestellt.
| Tiefensuche | Breitensuche | |
| Laufzeit | \mathcal{O}\: (|V| + |E|) | \mathcal{O}\: (|V| + |E|) |
| Speicherverbrauch | moderat | u.U. sehr umfangreich |
| Einsatzgebiete | ||
| Vorteile | geringer Speicherverbrauch | kürzeste Pfade |
| Nachteile | unvollständig bei Zyklen und endlosen Pfaden | hoher Speicherbedarf |
Es existiert nun ein Verfahren, das die Vorteile beider Durchlaufalgorithmen vereint, d.h. bei optimalem Speicherplatzverbrauch wird immer ein Ergebnis gefunden, ohne sich in Zyklen oder sehr langen Pfaden zu verlieren. Wir sprechen in diesem Fall von einer tiefenbeschränkten Suche.
Anwendung/ weiterführende Themen
Topologisches Sortieren
Die Topologische Sortierung reiht alle Knoten eines azyklischen Graphen G in einer Linie auf. u ligt vor v falls es in G eine Kante (u,v) gibt. Alle gerichteten Kanten zeigen nun von links nach rechts.
Topologisch sortierte Knoten eines Graphen G sind in der umkehrten Reihenfolge ihrer Endzeiten in der DFS angeordnet.
Topological-Sort(G)
- DFS(G) aufrufen um die Endzeiten f[u] für alle Knoten u zu bekommen
- jeden abgearbeiteten Knoten am Kopf einer Liste L einfügen
- L ist nun topologisch sortiert
Die topologische Sortierung wird zur Darstellung der Priorität von Ereignissen verwendet.
Das Beispiel:


Professor Bumstead führt eine topologische Sortierung seiner Kleidung durch, wenn er sich anzieht.
Wenn man entwas mit den Startwerten der DFS experimentiert, sieht man, dass sich aufgrund der verschiedenen Suchwälder auch verschiedene Topologische sortierungen einstellen. Es wird aber nie z.B. das Jacket vor der Kravatte angezogen. Die Position von isolierten Knoten(der Uhr) ist hingegen beliebig.
Euler und CPP
Eulerpfad/-kreis
Das Eulerkreis Problem hat seinen Ursprung in dem Vorhaben von Leonhard Eulers, alle fünf Stadtteile von Königsberg zu besuchen, dabei jede Brücke aber nur einmal zu überqueren und am Startpunkt wieder anzukommen.
Siehe dazu:Königsberger Brückenproblem
Bevor man versucht einen Eulerkreis zu finden, wird der Graph G geprüft, ob er überhaupt einen zulässt. Dazu ermittelt man den Grad aller Knoten und zählt wieviele geraden/ungeraden Grades sind.
- eulersch wenn:
- gerichtet und
- stark zusammenhängend
- bei jedem Knoten ist Eingangsgrad=Ausgangsgrad
- ungerichtet und
- zusammenhängend
- jeder Knoten hat geraden Grad
Wenn zwei oder kein Knoten ungeraden Grad haben, eistiert in einem ungerichteten, zusammenhängenden Graphen ein Eulerweg/pfad.
Auch wenn schnellere Algorithmen gibt(z.B. der Algorithmus von Hierholzer) wird hier der Algorithmus von Fleury kurz vorgestellt:
- Algorithmus von Fleury
- wähle beliebigen Startknoten u \in V(G)
- wähle eine an u angrenzende Kante, wähle zuerst Kanten die keine Brückenkanten sind
- füge die Kante der Liste des Eulerkreises hinzu, Kante markieren
- den anderen Knoten der gewählten Kante als neuen aktuellen knoten wählen
- existieren noch unmarkierte Kanten wieder zu Schritt 2
Laufzeit: \mathcal{O}(|E|^2) \leftarrow (Brückenkante finden \mathcal{O}(|E|), Kanten absuchen \mathcal{O}(|E|), Iterationen |E|
Vollständiger Graph mit 5 Ecken: Das Haus vom Nikolaus:

CPP
Das Chinese Postman Problem (dt. Briefträgerproblem) erhielt seinen Namen vom chinesischen Mathematiker Mei Ko Kwan, der das Problem erstmals 1962 untersuchte.
Inhalt des Problems ist die Frage nach dem besten Weg um Briefe zuzustellen. Jede Straße wird hierbei als Kante und jede Straßenkreuzung als Knoten in einem Straßennetzwerk(Graph) modelliert. Der Postbote muss nun jede Straße(Kante) genau einmal ablaufen, um alle Adressaten zu erreichen und dennoch nicht zu viel zu laufen.
Damit kann man das CPP lösen, wenn man einen Eulerkreis findet.
Leider sind reale Straßennetze nicht immer eulersch, das Thema soll hier jedoch nicht weiter vertieft werden.