Durchläufe durch Graphen SS12
Inhaltsverzeichnis |
Der Graphendurchlauf (engl. graph traversal) bildet die Grundlage vieler Graphenalgorithmen. Die Idee besteht darin, alle Knoten bzw. Kanten in einem Graphen systematisch zu besuchen, um beispielsweise Informationen über dessen Struktur zu sammeln.

Als Motivation für die Lösung dieses Problems soll folgendes Beispiel dienen: Eine Person befindet sich in einem Labyrinth, und sucht einen Ausgang, indem sie alle möglichen Kreuzungen von Gängen in Augenschein nimmt. Übertragen auf die Graphentheorie, existieren hierfür zwei bekannte algorithmische Lösungsverfahren, die Hauptgegenstand dieser Vorlesung sind. In unserem Beispiel sind die Gänge des Labyrinths die Kanten und alle Kreuzugen die Knoten des Graphen.
Stellen wir uns vor, die eingeschlossene Person folgt einem bestimmten Gang solange, bis sie in eine Sackgasse gerät, zur letzten Kreuzung zurückkehrt und einem anderen Weg auf die gleiche Art verfolgt. Dieses systematische Vordringen in die "Tiefe" nennen wir Tiefensuche. Sucht jedoch eine Gruppe von Leuten den Ausgang, so ist es wahrscheinlicher, dass sie gemeinsam vom Startpunkt ausschwärmen in die "Breite" vordringen. Analog dazu sprechen wir von einer Breitensuche.
Am Ende des Kapitels wird es uns möglich sein, das Labyrinth-Problem mithilfe der beiden Algorithmen zu lösen.
Hinweis: Im Folgenden wird häufig von Suche die Rede sein, obwohl es sich meistens eher um einen Durchlauf handelt. Durch die Übernahme der englischen Begrifflichkeiten DFS und BFS (depth-first und breadth-first search) haben sich die Bezeichnungen Tiefen- und Breitensuche anstelle von -durchlauf eingebürgert. Wir hoffen, damit kein allzu große Verwirrung zu stiften.
Note: Durchlauf (traversal) $\neq$ Suche (search)!
Achso, und laby etwas einfacher, vllt #6, zu demo-zwecken...
Applets:
//note to self2: applet: http://www.cosc.canterbury.ac.nz/mukundan/dsal/GraphAppl.html meh~
//note to self2.1: dfs-applet: http://www.lupinho.net/lupinho.de/gishur/html/DFSApplet.html
//note to self2.2: bfs-applet: http://www.lupinho.net/lupinho.de/gishur/html/BFSApplet.html
//w00t~
//note to self3: eu/hm-applets zum knobeln: http://www.cut-the-knot.org/Curriculum/Combinatorics/GraphPractice.shtml
//note to self4: laby-applet: http://www.swisseduc.ch/informatik/diskrete_mathematik/tiefensuche_labyrinth/applet.html
Wiederholung
Zum Verständnis der später vorgestellten Graphenalgorithmen sind grundlegende Kenntnisse über Graphen und spezielle Datenstrukturen notwendig, die jedoch bereits Themen in vorigen Veranstaltungen waren und im Folgenden nur aufgefrischt werden sollen.
Graphrepräsentation
\rightarrow siehe Vorlesung Graphrepräsentation
Kontrollfragen:
- Was ist der Unterschied zwischen gerichteten und ungerichteten Graphen?
Lösung
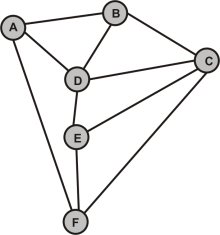 Ein ungerichteter Graph
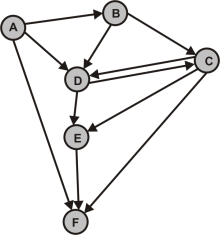 Ein gerichteter Graph
In einem ungerichteten Graphen kann eine Kante (u,v) in beliebiger Richtung überquert werden, während in einem gerichteten Graphen die zulässige Durchlaufrichtung durch einen Pfeil gekennzeichnet ist (ähnlich einer Einbahnstraße).
Will man einen ungerichteten Graphen gerichtet darstellen, so verdoppelt sich die Kantenmenge, d.h. enthält die Kantenmenge K des ungerichteten Graphen die Kante (u,v), muss die Kantenmenge K des gerichteten Graphen die Kanten (u,v) und (v,u) enthalten.
- Welche Darstellungsformen für Graphen gibt es?
- Wie können diese im Computer realisiert werden?
- Welche ist am besten?
Lösung
-
- Feld: Ein Adjazenzfeld ist eine sehr einfache Darstellungsform, in der alle Zielknoten in einem Array geordnet nach Startknoten gespeichert werden.
- Liste: Eine Adjazenzliste ist eine verkettete Liste mit Nachfolgern bzw. Nachbar eines Knotens.
- Matrix: Eine Adjazenzmatrix ist ein mehrdimensionales (V \times V mit V als Knotenanzahl) Array mit booleschen Variablen, in der a[u,v] auf 1 oder true gesetzt wird, wenn eine Kante (u,v) existiert. Analog dazu gibt eine Inzidenzmatrix (V \times E-großes Array) die Inzidenzbeziehungen zwischen Knoten und Kanten in einem Graphen an.
- Wir vergleichen die drei bzw. vier Darstellungsformen miteinander:
     Adjazenzfeld
     Adjazenzliste
     Adjazenzmatrix
     Inzidenzmatrix
Speicheraufwand \mathcal{O}\: (|V| + |E|) \mathcal{O}\: (|V| + |E|) \mathcal{O}\: (|V|^2) \mathcal{O}\: (|V| \cdot |E|) Nachbarabfrage \mathcal{O}\: (d)^*
* d = max. Ausgangsgrad\mathcal{O}\: (d)^*
* d = max. Ausgangsgrad\mathcal{O}\: (1) \mathcal{O}\: (|E|) Vorteile + kompakte Darstellung + kompakte Darstellung
+ effizient für dynamische Graphen+ schneller Zugriff
+ effizient bei dichten Graphen
+ schnelles Löschen von Kanten+ besser bei lichten Graphen Nachteile - nur für statische Graphen - ineffizient für dichte Graphen - hoher Speicheraufwand
- ineffizient bei lichten Graphen- hoher Speicheraufwand bei dichten Graphen
- langsames Löschen von KantenFazit: Die Anzahl der Kanten ist bei den meisten Graphen höher als die Knotenanzahl, daher ist aufgrund der schnellen Zugriffszeit die Adjazenzmatrix als Darstellungsform empfohlen.


Bäume und Preorder-Traversierung
\rightarrow siehe Vorlesung Sortierte Folgen
Datenstrukturen Stack und Queue
\rightarrow siehe Vorlesung Prioritätswarteschlangen
Kontrollfragen:
- Nach welchem Prinzip arbeitet eine Warteschlange?
Lösung
Eine Warteschlange (engl. queue) arbeitet nach dem FIFO-Prinzip, d.h. das Element, das zuerst in die Warteschlange abgelegt wurde, wird zuerst bearbeitet (ähnlich einer Schlange im Supermarkt).
Folgende Operationen sind notwendig:
- Element hinzufügen (enqueue): Das Element wird nach dem letzten Element eingefügt.
- erstes Element anzeigen (peek): Das zuerst hinzugefügte Element wird ausgegeben.
- Element löschen (dequeue): Das zuerst hinzugefügte Element wird ausgegeben und aus der Schlange entfernt.
- Prüfung, ob Schlange leer ist (isEmpty)
Implementierung:
- Nach welchem Prinzip arbeitet ein Stack?
- Element hinzufügen (push): Das Element wird an erster Stelle eingefügt.
- erstes Element anzeigen (peek): Das zuletzt hinzugefügte Element wird ausgegeben.
- Element löschen (pop): Das zuletzt hinzugefügte Element wird ausgegeben und aus dem Stack entfernt.
- Prüfung, ob Stack leer ist (isEmpty)
Lösung
Im Gegensatz zur Warteschlange arbeitet ein Stack nach dem LIFO-Prinzip, d.h. das Element, das zuletzt auf den Stack abgelegt wurde, wird zuerst bearbeitet (ähnlich einem Stapel Bücher etc.).
Folgende Operationen sind notwendig:
Implementierung:
Grundlagen zum Graphendurchlauf
Allgemeiner Durchlauf-Algorithmus
Unsere zentrale Frage lautet: Wie können wir die Knoten eines Graphen durchlaufen, sodass jeder Knoten mindestens einmal besucht wird?
Um am Ende eine vernünftige Durchlaufordnung angeben zu können, überlegen wir uns folgendes Verfahren:
- Graph G als Adjazenzlisten- oder -matrixdarstellung
- eine Menge von Knoten v \in V mit den Zuständen unbesucht und besucht
- eine Arbeitsliste L, die besuchte aber noch nicht abgearbeitete Knoten beinhaltet.
- Initialisierung: nur der Startknoten v ist mit besucht markiert und befindet sich in der Arbeitsliste L
- solange L nicht leer ist:
- wähle einen Knoten v aus L
- wähle und markiere einen unbesuchten Nachbarn u von v als besucht und speichere u in die Arbeitsliste L
- falls v keine unbesuchten Nachbarn besitzt, entferne v aus L
Algorithmus: Graphendurchlauf_allgemein (Graph G, Knoten v \in V(G), Arbeitsliste L)
\begin{array}{l|l}
1 & v \leftarrow besucht\\
2 & L \leftarrow L \oplus v\\
3 & \mathbf{while}\; (L \neq\: \emptyset)\; \mathbf{do} \\
4 &\;\;\;\;\; \text{\small waehle Knoten } v \in L \\
5 &\;\;\;\;\;\; \mathbf{if}\; (\!\text{\small es gibt } u \in V(G) \text{\small mit } u=Nachbar\; von\; v \text{\small und } u=unbesucht)\; \mathbf{then} \\
6 &\;\;\;\;\;\;\;\;\;\;\;\; u \leftarrow besucht\\
7 &\;\;\;\;\;\;\;\;\;\;\;\; L \leftarrow L \oplus u\\
8 &\;\;\;\;\;\; \mathbf{else}\; L \leftarrow L \ominus u \\
\end{array}
end Graphendurchlauf_allgemein
Die Arbeitsliste L
Die Art und Weise wie die einzelnen besuchten Knoten in die Arbeitsliste L eingefügt werden sollen, ist beim Graphendurchlauf von großer Bedeutung. Hierfür gibt es zwei Möglichkeiten.
Die Arbeitsliste als Stack
Wird die Arbeitsliste als Stack implementiert, wird jeder besuchte Knoten nach dem LIFO-Prinzip eines Stacks auf L abgelegt.
Arbeitsweise:
- markiere den Startknoten v als besucht und legen ihn auf den leeren Stack ab
- solange der Stack nicht leer ist:
- ermittle alle unbesuchten Nachbarn des obersten Knotens v im Stack und lege sie auf den Stack ab
- falls der oberste Knoten keine unbesuchten Nachbarn besitzt, entferne ihn aus dem Stack und fahre mit dem neuen ersten Element fort.
Mit dieser Implementierung lässt sich die Tiefensuche realisieren.
Die Arbeitsliste als Queue

Wird die Arbeitsliste dagegen als Queue implementiert, werden die besuchten Knoten nach dem FIFO-Prinzip einer Warteschlange an L angefügt.
Arbeitsweise:
- markiere den Startknoten v als besucht und füge ihn in die leere Queue ein
- solange die Queue nicht leer ist:
- ermittle alle unbesuchten Nachbarn des ersten Knotens v in der Queue und hänge sie an die Warteschlange an
- falls v keine unbesuchten Nachbarn besitzt, entferne v aus der Queue und fahre mit dem neuen ersten Element fort
Mit dieser Implementation kann die Breitensuche realisiert werden.
Unsere interne Graphenrepräsentation
- definitionen von graph, vertex, edge und was sonst nicht alles
- kleine demonstrationen
Tiefensuche
- allgemeines
Iterativ mit Stack
Algorithmus: Tiefendurchlauf (Graph G, Knoten v \in V(G), Stack S)
\begin{array}{l|l}
1 & v \leftarrow besucht\\
2 & S \leftarrow push(v)\\
3 & \mathbf{while}\; (S \neq\: \emptyset)\; \mathbf{do} \\
4 &\;\;\;\;\; \text{\small waehle Knoten } v \in S \text{\small mit } v = peek(S) \\
5 &\;\;\;\;\;\; \mathbf{if}\; (\!\text{\small es gibt } u \in V(G) \text{\small mit } u=Nachbar\; von\; v \text{\small und } u=unbesucht)\; \mathbf{then} \\
6 &\;\;\;\;\;\;\;\;\;\;\;\; u \leftarrow besucht\\
7 &\;\;\;\;\;\;\;\;\;\;\;\; S \leftarrow push(u)\\
8 &\;\;\;\;\;\; \mathbf{else}\; S \leftarrow pop(u) \\
\end{array}
end Tiefendurchlauf
Rekursiver Tiefen-Durchlauf-Algorithmus
Um alle Knoten in einem Graphen durchlaufen und am Ende eine vernünftige Durchlaufordnung angeben zu können, überlegen wir uns folgendes Verfahren:
- Eingaben:
- Graph G als Adjazenzlisten- oder -matrixdarstellung
- Eine Menge von Knoten mit den Zuständen:
- farbe=weiss für unbesuchte Knoten
- farbe=grau für besuchte Knoten
- farbe=schwarz für abgeschlossene Knoten
- pi=nil (der Vorgänger)
- d[u]=0 (die Zeit der Entdeckung)
- f[u]=0 (die Zeit des Abschließens)
- Algorithmus:
- Initialisierung: alle Knoten V(G) werden mit weiss und nil belegt, zeit=0
- solange L nicht leer ist:
- wähle einen Knoten v aus L
- wähle und markiere einen unbesuchten Nachbarn u von v als besucht und speichere u in die Arbeitsliste L
- besitzt v keine unbesuchte Nachbarn, entferne v aus L
Algorithmus: Graphendurchlauf_allgemein (Graph G, Knoten v \in V(G), Arbeitsliste L)
\begin{array}{l|l} 1 & v \leftarrow besucht\\ 2 & L \leftarrow L \oplus v\\ 3 & \mathbf{while}\; (L \neq\: \emptyset)\; \mathbf{do} \\ 4 &\;\;\;\;\; \text{\small waehle Knoten } v \in L \\ 5 &\;\;\;\;\;\; \mathbf{if}\; (\!\text{\small es gibt } u \in V(G) \text{\small mit } u=Nachbar\; von\; v \text{\small und } u=unbesucht)\; \mathbf{then} \\ 6 &\;\;\;\;\;\;\;\;\;\;\;\; u \leftarrow besucht\\ 7 &\;\;\;\;\;\;\;\;\;\;\;\; L \leftarrow L \oplus u\\ 8 &\;\;\;\;\;\; \mathbf{else}\; L \leftarrow L \ominus u \\ \end{array}
end Graphendurchlauf_allgemein
Breitendurchlauf/ -suche
Abgeleitet von der allgemeinen Durchlaufvorschrift unter Benutzung einer Warteschlange Q als Arbeitsliste, beschreibt folgender Algorithmus die Arbeitsweise der Breitensuche.
Algorithmus: Breitendurchlauf (Graph G, Knoten v \in V(G), Queue Q)
\begin{array}{l|l}
1 & v \leftarrow besucht\\
2 & Q \leftarrow enqueue(v)\\
3 & \mathbf{while}\; (Q \neq\: \emptyset)\; \mathbf{do} \\
4 &\;\;\;\;\; \text{\small waehle Knoten } v \in Q \text{\small mit } v = peek(Q) \\
5 &\;\;\;\;\;\; \mathbf{if}\; (\!\text{\small es gibt } u \in V(G) \text{\small mit } u=Nachbar\; von\; v \text{\small und } u=unbesucht)\; \mathbf{then} \\
6 &\;\;\;\;\;\;\;\;\;\;\;\; u \leftarrow besucht\\
7 &\;\;\;\;\;\;\;\;\;\;\;\; Q \leftarrow enqueue(u)\\
8 &\;\;\;\;\;\; \mathbf{else}\; Q \leftarrow dequeue(u) \\
\end{array}
end Breitendurchlauf
- code-simu
1 |
public Object Vertex (char label) { char label = label; boolean bereitsBesucht = false; String farbe = "weiss" ; int gefunden = -1; int abgearbeitet = -1; char vorgaenger = '#' ; return this ; } |