Einführung SS12
Inhaltsverzeichnis |
Effizienzbegriff
Qualitative Beschreibung von Effizienz
- Ein Algorithmus heißt effizient, wenn er ein vorgegebenes Problem mit möglichst geringem Ressourcenaufwand (Zeit, Speicher) löst.
Diese Beschreibung hält einer quantitativen Bewertung effizienter Algorithmen nicht stand und muss von daher präzisiert werden. Außerdem ist zu beachten, dass Zeit und Speicher ineinander "umwandelbar" sind. D.h., wenn man bei der Modellierung möglichst knappen Speicher wählt, kann es sein, dass dies die Berechnungskomponente des Algorithmus' belastet: Ein Zusatzaufwand kann erforderlich sein, da gewisse Daten zwischengerechnet werden müssen, weil sie nicht direkt zur Verfügung stehen.
Wir werden uns im Folg. im Wesentl. der Zeiteffizienz von Algorithmen widmen.
Problem und Instanzen eines Problems
Es ist bekannt, dass ein betrachtetes Programm für verschiedene Eingaben verschiedene Rechenzeiten zur Bestimmung der entsprechenden Ausgaben benötigt. Wenn wir an einen Primzahltest durch Probeteiler für eine zu untersuchende natürliche Zahl n denken, ist das nicht verwunderlich: Für sehr große Primzahlen ist das wesentlich aufwändiger als für kleine Zahlen, denn es gibt viel mehr Teilerkandidaten.
Häufig ist es außerdem so, dass die Bearbeitungen "vergleichbarer" Eingaben völlig verschiedene Zeitaufwände erfordern. In unserem Primzahltest-Beispiel erfordert die Untersuchung der Zahl 49 bereits vier Probeteiler, nämlich 2,3,5,7, während für 50 schon im ersten Schritt klar ist, dass sie keine Primzahl sein kann, weil sie gerade ist.
Das Beispiel zeigt, dass es falsch wäre zu sagen, dass der Berechnungsaufwand mit zunehmender Problemgröße n steigt. Es gibt vielmehr "solche und solche" Kandidaten nahezu gleicher Größe. Als Größe legen wir die Stelligkeit der gewählten Darstellung, z.B. zweistellige Zahlen im Dezimalsystem, fest.
Deshalb macht es Sinn, die Eingabewerte in Gruppen gleicher Größe einzuteilen. Im Beispiel untersuchen wir also den Aufwand für den Primzahltest für n-stellige Zahlen. Für jede Gruppe, z.B. n=10, 100, 1000, 10000, 100000, 1000000, wählen wir z.B. k=5 Kandidaten zufällig aus und ermitteln die zugehörigen Zeitaufwände. Die folgende Tabelle zeigt den Kern unserer experimentellen Vorgehensweise.
| n | 1 | 2 | 3 | 4 | 5 | T(n) |
|---|---|---|---|---|---|---|
| 10 | ... | ... | ... | ... | ... | .?. |
| 100 | ... | ... | ... | ... | ... | .?. |
| 1000 | ... | ... | ... | ... | ... | .?. |
| 10000 | ... | ... | ... | ... | ... | .?. |
| 100000 | ... | ... | ... | ... | ... | .?. |
| 1000000 | ... | ... | ... | ... | ... | .?. |
Wenn wir uns nun vorstellen, dass die Pünktchen durch die ermittelten Rechenzeiten (z.B. als Takte einer abstrakten Maschine; s. weiter unten) ersetzt wurden, bleibt die Frage nach dem Ersatz des jeweils zugehörigen Fragezeichens.
Je nach Analysetyp macht es Sinn entweder das Maximum, das Minimum bzw. den Durchschnitt zu bestimmen:
- worst-case-Analyse: liefert eine (sichere) Aussage zum schlechtestmöglichen Aufwandsverhalten.
- best-case-Analyse: gibt die bestmögliche Performance-Erwartung (eher unpraktikel).
- average-case-Analyse: Wenn die Differenz zwischen worst- und best-case-Analyse sehr groß ist, gibt die average-case-Analyse mehr Aufschluss.
In obigen Ausdrücken steht I_n für die Menge der Instanzen der Problemgröße n und k bezeichnet die Anzahl der Instanzen der Größe n, d.h. k=|I_n|.
Für die Bestimmung der jeweiligen Rechenzeit käme prinzipiell natürlich eine Stoppuhr (Handy mit Stopp-App o.ä.) infrage. Diese Methode wäre allerdings sehr fehleranfällig.
Übungsaaufgabe: Begründen Sie diese Aussage.
Deshalb führen wir die Zeitmessung auf die Bestimmung der erforderlichen Arbeitstakte einer abstrakten Maschine zurück -- ganz nach dem Vorbild der atomaren Operationen bei der Karatsuba-Multiplikation zweier natürlicher Zahlen.
Beispiele
Binäre Suche
Gegeben sind eine aufsteigend sortierte Liste (a_1,a_2,\ldots,a_n), mit a_1<a_2<\ldots <a_n,\; n>0, und ein in dieser Liste enthaltenes Element x=a_k. Gesucht ist k.
Der Algorithmus arbeitet nach dem Prinzip "Teile und herrsche":
- Wähle m=\left\lceil\frac{n}{2}\right\rceil.
- Falls x=a_m, gilt k:=m. Stopp.
- Falls x<a_m, suche weiter in (a_1,a_2,\ldots,a_m).
- Falls x>a_m, suche weiter in (a_{m+1},a_{m+2},\ldots,a_n).
Zur Aufwandsabschätzung nehmen wir vereinfachend an, dass n eine Zweierpotenz ist, also n=2^d, mit d\in\mathbb{N}. Im worst case sind dann genau d=\log_2n Teilungen der anfangs gegebenen Liste (a_1,a_2,\ldots,a_n) möglich.
Da die Aufwände für die Berechnung von m und die Vergleiche von x mit a_m bei jedem Aufruf der Suchprozedur einen konstanten Wert c haben, kann man den Gesamtaufwand im worst case mit \mathcal{O}(\log_2n) ansetzen.
Die best-case-Analyse führt hingegen zu \mathcal{O}(1): Man denke nur daran, dass das gesuchte x gleich beim ersten Vergleich gefunden wird.
Auf die Untersuchung des average case wollen wir hier verzichten. Hierfür wäre es notwendig, entsprechende Betrachtungen mit Wahrscheinlichkeiten durchzuführen.
Dublettensuche in einer (unsortierten) Liste
Gegeben ist eine unsortierte Liste (a_1,a_2,\ldots,a_n), n>0, natürlicher Zahlen.
Gesucht ist das Element, das als mehrfach (mindestens zweimal) in der Liste vorkommt. Ist ein solches Element a_k überhaupt vorhanden, stoppt der Algorithmus mit dessen Ausgabe, andernfalls gibt er nichts aus. Gesucht ist also das kleinste k, 1\leq k,m\leq n, mit a_k=a_m und k<m.
1. Verfahren
Ein stringentes Verfahren zur Dublettensuche vergleicht jedes Listenelement mit allen Elementen, die diesem in der Liste folgen, also a_i wird verglichen mit a_{i+1},a_{i+2},\ldots,a_{n}. Für i=1,2,\dots,n-1} sind das n-1, n-2,\ldots,1=\sum\limits_{j=1}^{n-1}=\frac{n(n-1)}{2} Vergleiche jeweils konstanten Aufwands. Damit ist klar, dass der Aufwand im worst case in \mathcal{O}(n^2)$ liegt.
Wir wollen das experimentell untermauern.
Die folgende Prozedur stellt eine Liste mit n=30 Zufallszahlen aus dem Intervall [0,m[ bereit, m=100.
Die Dublettensuche wird durch zwei verschachtelte Laufanweisungen (do-Schleifen) realisiert. Die darin enthaltene Variable escape sorgt dafür, dass der Zyklus verlassen wird, sobald eine Dublette gefunden wurde. Außerdem wird die Zahl der Vergleiche ausgegeben.
Übungsaufgabe: Führen Sie eine empirische worst-case-Analyse durch und vergleichen Sie Ihr Ergebnis mit der Vorhersage eines quadratischen Aufwands.
2. Verfahren
Eine aus dem Hashing bekannte Idee liefert ein wesentlich schnelleres Dublettsuchverfahren. Es braucht allerdings auch viel mehr Speicher. Das ist keine Seltenheit: Gibt man mehr Speicher, kann der darüber arbeitende Prozess Rechenzeit einsparen. Umgekehrt haben Speichersparmaßnahmen mitunter negative Auswirkungen auf die Performance.
Die Idee besteht darin, für jedes Element A[i] des Zufallsvektors in einem zweiten Vektor B[A[i]] dessen Existenz zu vermerken. Der Wert des Elements ist also der betreffende Index von B. Vektor B wird mit false initialisiert, was so viel bedeutet, wie dass das betrachtete Element beim Durchlaufen des Vektors (mit aufsteigendem Index) noch nicht vorkam. Für jedes Element wird true in B[A[i]] vermerkt, wenn der vorherige Wert false war. Ist der ursprüngliche Wert jedoch true, so ist klar, dass der betrachtete Wert (als Listenelement) bereits vorhanden ist, d.h. eine Dublette wurde gefunden.
Wenn wir also Zufallszahlen aus [0,m[ zulassen, liegt der Index von Vektor B zwischen 0 und dem Maximum aller Werte aus A, wobei \max(a_i)<m. Da die Bestimmung dieses Maximums bereits bei der Zufallslistenbildung erledigt werden kann, wird der dafür erforderliche (einmale) Aufwand nicht veranschlagt. Verwendet man (etwas verschwenderisch) einfach m, entfällt er gänzlich.
Wie wir sehen können, finden maximal n-1, bei n=20 also 19, Vergleiche statt.
Polynomialer vs. exponentieller Aufwand
Polynomialer Aufwand:
T(n)=a_r n^r + a_{r-1} n^{r-1} + \ldots + a_1 n^1 + a_0 = \sum\limits_{i=0}^ra_i,\text{ mit } r\in\mathbb{N}_0,~a_r,\ldots, a_0\in\mathbb{R}_0^+,~a_r\neq 0.Hierzu zählen auch die Aufwandsfunktionen, die sich mit Logarithmen der folgenden Form T(n)=a\cdot\log_c n beschreiben lassen. Man spricht von quasipolynomialen Aufwänden.
Exponentieller Aufwand:
T(n)=c\cdot z^n, \text{ wobei }z,~c\in\mathbb{R},~c\neq0\text{ und } z>1.Auch die Fakultätsfunktion beschreibt einen exponentiellen Zusammenhang, wie die Stirlingsche Formel zeigt:
n!\approx \sqrt{2\pi n}\left(\frac{n}{e}\right)^n.Aufgrund des gegebenen Definitionsbereiches bestehen die Graphen der Funktionen eigentlich aus Punkten. Zur besseren Visualisierung werden sie jedoch als geschlossene Linienzüge dargestellt.
Vergleich verschiedener polynomialer und pseudopolynomialer Aufwände
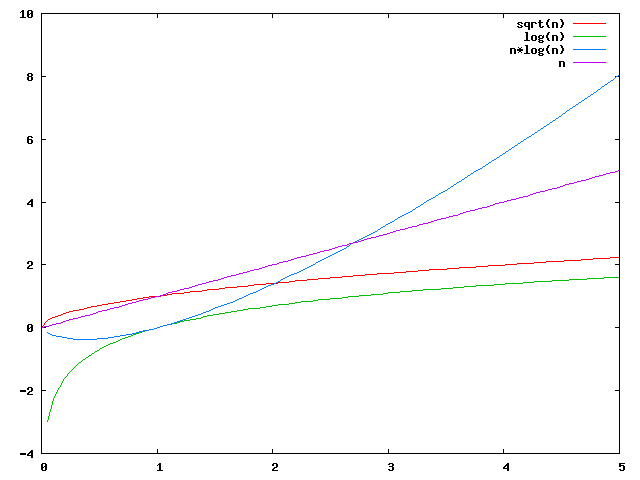
Asymptotische Aufwandsordnungen
Kleine Zeitaufwände zu vergleichen ist nicht sinnvoll. Schon Computer geringer Leistungsfähigkeit rechnen in diesem Bereich sehr schnell. Dem gegenüber kann es für große und sehr große Werte für n dazu kommen, dass auch sehr leistungsstarke Prozessoren unakzeptable Rechenzeiten beanspruchen.
Bei der Beurteilung des Aufwandsverhaltens ist deshalb im Allg. nicht von Interesse, welche Koeffizienten in dem konkreten Funktionsausdruck für T vorkommen. Dies führt zur asymptotischen Analyse.
Insbesondere haben zwei Funktionen f,t:\mathbb{N}\mapsto\mathbb{R}_0^+ die gleichen Wachstumsraten, wenn es zwei positive reelle Konstanten c und d gibt, so dass für alle hinreichend großen n gilt c\leq\frac{f(n)}{t(n)}\leq d, d.h. wenn f schneller wächst als t und für eine positive reellen Konstanten c gilt f(n)\geq c\cdot t(n).
Für die mathematische Beschreibung dieses Sachverhalts wird die "Groß-O"-Notation verwendet. Die Sprechweise von \mathcal{O}(f) ist "Groß-O von f". Mit dem \mathcal{O}-Kalkül werden wir uns am meisten beschäftigen. \begin{eqnarray*}
 \mathcal{O}(f) &=& \{t:\mathbb{N}\mapsto\mathbb{R}_0^+\mid \exists c\in\mathbb{R}^+\ \exists n_0\in\mathbb{N}\ \forall n\geq n_0:\ t(n)\leq c\cdot f(n)\} \\
 \Omega(f) &=& \{t:\mathbb{N}\mapsto\mathbb{R}_0^+\mid \exists c\in\mathbb{R}^+\ \exists n_0\in\mathbb{N}\ \forall n\geq n_0:\ t(n)\geq c\cdot f(n)\} \\
 \Theta(f) &=& \mathcal{O}(f)\cap \Omega(f)
\end{eqnarray*}
Beispielsweise hat die Karatsuba-Multiplikation zur Multiplikation zweier n-stelliger natürlicher Zahlen einen Aufwand in \mathcal{O}(n^{1.58}) und die Schulbuchmethode in \mathcal{O}(n^{2}).
Hinweis zur Ausprache und Schreibweise
Man sagt: "Das Programm hat einen Aufwand in \mathcal{O}(f). Außerdem hat sich die Schreibweise \mathcal{O}(n^{k}) fest etabliert, obwohl es strenggenommen \mathcal{O}(n\mapsto n^{k}) heißen müsste. Da klar ist, dass der Definitionsbereich stets die Menge der natürlichen Zahlen ist und die Aufwandsfunktion einstellig ist, lässt man dies eben weg.
Man sollte sich klar machen, dass \mathcal{O}(f) eine Menge von Funktionen ist, s. Definition weiter oben. Offensichtlich gilt für einen polynomialen Aufwand der Form
T(n)=\sum\limits_{i=0}^k a_i\cdot n^i,\text{ mit } a_k>0T\in\Theta(n^k), d.h. T\in\mathcal{O}(n^k) und T\in\Omega(n^k), denn T(n)\leq \underbrace{\sum\limits_{i=0}^k a_i}_{c}\; \cdot\; \underbrace{n^k}_{f(n)}.
Hiernach gilt (wiederum in gängiger Kurzschreibweise) 3n^2+8n=\mathcal{O}(n^2). Der Grad des Polynoms regiert die Aufwandsordnung.
Hinweis zur Schreibweise
Statt (korrekt) n\mapsto 3n^2+8n\in\mathcal{O}(n^2) schreibt man (schlampig) 3n^2+8n=\mathcal{O}(n^2)
Bei einer etwas gröberen (nicht zu empfehlenden aber möglichen) Abschätzung nach oben wäre allerdings auch 3n^2+8n=\mathcal{O}(n^3) richtig. Folglich könnte man schreiben: 3n^2+8n=\mathcal{O}(n^2)=\mathcal{O}(n^3). Obwohl es sich formal um eine Gleichheit handelt, gilt diese Beziehung nur von links nach rechts gelesen. Das ist sehr wichtig und außergewöhnlich, aber z.B. für g(n)=4n^3 gelten nun mal g\in\mathcal{O}(n^3) und g\not\in\mathcal{O}(n^2).
Übungsaufgaben:
Mitunter ist es notwendig, mit asymptotischen Aufwänden zu rechnen. Dann gelten beispielsweise die folgenden Verknüpfungen. ...